Previsão (forecasting), simulação de cenários e análise de séries temporais
Rodrigo Hermont Ozon
junho 01, 2021
Economic Time Series Forecasting
Uma série temporal é um conjunto de observações dos valores que uma variável assume em diferentes momentos do tempo. Enquanto que o forecasting envolve fazer previsões sobre o futuro. É necessário em muitas situações: - decidir se construirá outra usina de geração de energia nos próximos dez anos requer previsões de demanda futura; - agendar equipe em um call center na próxima semana exige previsões de volumes de chamadas; - armazenar um estoque requer previsões de necessidades de estoque. As previsões podem ser exigidas com vários anos de antecedência (para o caso de investimentos de capital), ou apenas alguns minutos antes (para roteamento de telecomunicações). Quaisquer que sejam as circunstâncias ou horizontes de tempo envolvidos, a previsão (forecasting) é uma ajuda importante para um planejamento eficaz e inteligente.
\[\\[1in]\]
Introdução
Esse relatório capta dinamicamente as cotações dos seguintes ativos relacionados as negociações da commoditie milho:
CORNCORN (Teucrium Corn Fund) \(\Rightarrow\) última cotação2021-06-01.CN21.CBTCN21.CBT \(\Rightarrow\) Não utilizado como objeto de análise aqui aindaCz21.CBTCz21.CBT \(\Rightarrow\) Não utilizado como objeto de análise aqui aindaCU21.CBTCU21.CBT \(\Rightarrow\) Não utilizado como objeto de análise aqui aindaCH22.CBTCH22.CBT \(\Rightarrow\) Não utilizado como objeto de análise aqui aindaCK22.CBTCK22.CBT \(\Rightarrow\) Não utilizado como objeto de análise aqui aindaZC=FZC=F \(\Rightarrow\) Não utilizado como objeto de análise aqui ainda
Os dados são oriundos do Yahoo finance. As séries temporais se iniciam em 01/01/2018 e terminam no último valor de fechamento disponível na série, quase que em real time.
Carregando as bibliotecas necessárias
library(lmtest)
library(quantmod)
library(dygraphs)
library(tidyverse)
library(dplyr)
library(plotly)
library(ggplot2)
library(forecast)
library(astsa)
library(prophet)
library(DT)
library(fpp2)
library(tsbox)
library(lubridate)
library(data.table)
library(tseries)
Uma série temporal é um conjunto de observações dos valores que uma variável assume em diferentes momentos do tempo. Esses dados podem ser coletados a intervalos regulares, como diariamente (preços das ações, relatórios meteorológicos), semanalmente (informações sobre oferta de moeda), mensalmente (taxa de desemprego, índice de preços ao consumidor [IPC]), trimestralmente (PIB), anualmente (orçamento do governo), quinquenalmente, isto é, a cada cinco anos (censo industrial dos Estados Unidos), ou decenalmente (censo demográfico). Às vezes, os dados estão disponíveis em séries trimestrais e anuais, como no caso do PIB e das despesas de consumo. Com o advento dos computadores de alta velocidade, os dados agora podem ser coletados a intervalos extremamente curtos, como os relativos a preços das ações, obtidos de forma praticamente contínua (as chamadas cotações em tempo real).
A maioria dos estudos empíricos na econometria das séries temporais embasados nesse tipo de dado pressupõe que a série temporal subjacente seja estacionária. De maneira geral, uma série é estacionária se sua média e variância não variam sistematicamente ao longo do tempo, ou em termos não exatos, uma série temporal, por exemplo, \(Y_t\), é estacionária se sua média e sua variância não mudam sistematicamente ao longo do tempo.
CORN <- getSymbols("CORN", auto.assign = FALSE,
                    from = "2010-01-01", end = Sys.Date())
glimpse(CORN) # Perfil dos dadosAn 'xts' object on 2010-06-09/2021-05-28 containing:
Data: num [1:2763, 1:6] 25.1 25.5 25.9 26 26.2 ...
- attr(*, "dimnames")=List of 2
..$ : NULL
..$ : chr [1:6] "CORN.Open" "CORN.High" "CORN.Low" "CORN.Close" ...
Indexed by objects of class: [Date] TZ: UTC
xts Attributes:
List of 2
$ src : chr "yahoo"
$ updated: POSIXct[1:1], format: "2021-06-01 16:57:55"dygraph(Cl(CORN)) # Fechamentodygraph(Vo(CORN)) # Volume negociado
"Por que as séries temporais estacionárias são tão importantes? Porque, se uma série temporal é não estacionária, podemos estudar seu comportamento apenas pelo período de tempo em consideração. Cada conjunto de dados de série temporal, portanto, será específico a cada episódio. Como consequência, não é possível generalizá-lo para outros períodos. Sendo assim, para o propósito de previsão, tal série temporal (não estacionária) pode ser de pouco valor prático." (Gujarati e Porter, p. 735, 2011)
# Manipulo pra selecionar as variaveiss necessarias

CORN_df <- as.data.table(CORN)
glimpse(CORN_df)
Rows: 2,763
Columns: 7
$ index <date> 2010-06-09, 2010-06-10, 2010-06-11, 2010-06-14, 2010-06~
$ CORN.Open <dbl> 25.12, 25.46, 25.88, 25.99, 26.24, 26.26, 26.20, 26.22, ~
$ CORN.High <dbl> 25.25, 25.46, 25.88, 26.11, 26.24, 26.44, 26.20, 26.60, ~
$ CORN.Low <dbl> 25.12, 25.46, 25.79, 25.99, 25.97, 26.20, 25.82, 26.22, ~
$ CORN.Close <dbl> 25.15, 25.46, 25.79, 26.11, 25.97, 26.32, 26.08, 26.39, ~
$ CORN.Volume <dbl> 1700, 200, 500, 2200, 7000, 2400, 1600, 3100, 9500, 2870~
$ CORN.Adjusted <dbl> 25.15, 25.46, 25.79, 26.11, 25.97, 26.32, 26.08, 26.39, ~CORN_df <- CORN_df %>%
rename(Date = "index")
glimpse(CORN_df)Rows: 2,763
Columns: 7
$ Date <date> 2010-06-09, 2010-06-10, 2010-06-11, 2010-06-14, 2010-06~
$ CORN.Open <dbl> 25.12, 25.46, 25.88, 25.99, 26.24, 26.26, 26.20, 26.22, ~
$ CORN.High <dbl> 25.25, 25.46, 25.88, 26.11, 26.24, 26.44, 26.20, 26.60, ~
$ CORN.Low <dbl> 25.12, 25.46, 25.79, 25.99, 25.97, 26.20, 25.82, 26.22, ~
$ CORN.Close <dbl> 25.15, 25.46, 25.79, 26.11, 25.97, 26.32, 26.08, 26.39, ~
$ CORN.Volume <dbl> 1700, 200, 500, 2200, 7000, 2400, 1600, 3100, 9500, 2870~
$ CORN.Adjusted <dbl> 25.15, 25.46, 25.79, 26.11, 25.97, 26.32, 26.08, 26.39, ~
"Na análise aplicada, os dados brutos muitas vezes são “manipulados”. Por exemplo, em regressões de séries temporais que envolvem dados trimestrais, muitas vezes os dados são obtidos somando três observações mensais e dividindo a soma por três. Essas médias suavizam os dados amenizando as flutuações dos dados mensais. Portanto, a representação gráfica dos dados trimestrais é muito menos irregular que a dos dados mensais e essa mesma regularidade pode gerar um padrão sistemático nos termos de erro, introduzindo a autocorrelação." (Gujarati e Porter, p. 419, 2006)
# Transformo em serie temporal diária para dados mensal

CORN <- ts(CORN_df[-1], start = c(2010, 6), end = c(2021, 5), frequency = 12)

head(CORN) # Primeiras 5 observações do conjunto de dados
Date CORN.Open CORN.High CORN.Low CORN.Close CORN.Volume
Jun 2010 14770 25.46 25.46 25.46 25.46 200
Jul 2010 14771 25.88 25.88 25.79 25.79 500
Aug 2010 14774 25.99 26.11 25.99 26.11 2200
Sep 2010 14775 26.24 26.24 25.97 25.97 7000
Oct 2010 14776 26.26 26.44 26.20 26.32 2400
Nov 2010 14777 26.20 26.20 25.82 26.08 1600
CORN.Adjusted
Jun 2010 25.46
Jul 2010 25.79
Aug 2010 26.11
Sep 2010 25.97
Oct 2010 26.32
Nov 2010 26.08tail(CORN) # Ultimas 5 observações do conjunto de dados Date CORN.Open CORN.High CORN.Low CORN.Close CORN.Volume
Dec 2020 14951 35.28 36.35 35.20 36.25 34200
Jan 2021 14952 36.10 36.45 36.10 36.34 34600
Feb 2021 14953 36.26 36.26 35.79 36.16 44900
Mar 2021 14956 36.35 37.00 36.35 36.75 54600
Apr 2021 14957 36.94 36.95 36.70 36.76 30900
May 2021 14958 36.97 37.19 36.33 36.51 53200
CORN.Adjusted
Dec 2020 36.25
Jan 2021 36.34
Feb 2021 36.16
Mar 2021 36.75
Apr 2021 36.76
May 2021 36.51glimpse(CORN) Time-Series [1:132, 1:7] from 2010 to 2021: 14770 14771 14774 14775 14776 ...
- attr(*, "dimnames")=List of 2
..$ : NULL
..$ : chr [1:7] "Date" "CORN.Open" "CORN.High" "CORN.Low" ...colnames(CORN) # Mostre somente os nomes das colunas[1] "Date" "CORN.Open" "CORN.High" "CORN.Low"
[5] "CORN.Close" "CORN.Volume" "CORN.Adjusted"Em especial, como analisaremos aqui dados de séries temporais econômico-financeiras, os pesquisadores deste fenômeno até então que buscam pela sua modelagem ideal encontraram os seguintes fatos estilizados:
Séries econômicas e financeiras apresentam algumas características que são comuns a outras séries temporais, como: (a) tendências; (b) sazonalidade; (c) pontos influentes (atípicos); (d) heteroscedasticidade condicional; (e) não-linearidade. O leitor está, certamente, familiarizado com as caracteríticas acima; para detalhes, veja Franses (1998). Dessas, a última talvez seja a mais complicada de definir. De um modo bastante geral, podemos dizer que uma série econômica ou financeira é não-linear quando responde de maneira diferente a choques grandes ou pequenos, ou ainda, a choques negativos ou positivos. (Morettin, p. 18, 2006)
A respeito disso, trataremos mais adiante sobre a aplicação de Vetores Autoregressivos e em especial de suas Funções de Impulso-Resposta e Decomposição de Variância, onde avaliaremos o horizonte estimado de tempo no futuro dado que alguma variável estudada sofra algum tipo de choque de quaisquer magnitude.
Em relação ao padrão de heterocedasticidade condicional e pontos atípicos presentes na volatilidade dos ativos financeiros, uma boa aplicação se dá com o uso dos modelos da família ARCH.
Os modelos que captam tendência e sazonalidade, em especial podem ser ajustados a cada série univariada ou em conjunto com a aplicação de modelos SARIMA, p. ex.
Causalidade x modelos de regressão em séries temporais
Embora a análise de regressão lide com a dependência de uma variável sobre outras variáveis, ela não implica necessariamente causação. Nesses modelos, uma premissa básica é que a relação de causa e efeito, se houver, entre o \(Y\) e os \(X\) é unidirecional. As variáveis explanatórias são a causa e a variável dependente é o “efeito”.
Entretanto, há situações nas quais existe um fluxo de influência de mão dupla entre as variáveis econômicas; ou seja, uma variável econômica afeta outra(s) variável(eis) econômica(s) e é, por sua vez, afetada por ela(s).
Em outras palavras, a existência de uma relação entre variáveis não prova causalidade ou a direção da influência. Mas, em regressões envolvendo dados de séries temporais, a situação pode ser um pouco diferente, porque, como coloca o autor,
[. . .] o tempo não volta. Ou seja, se o evento A acontece antes do evento B, então é possível que A esteja causando B. No entanto, não é possível que B esteja causando A. Em outras palavras, os eventos passados podem levar ao acontecimento de eventos no presente. Os eventos futuros não podem. (Koop, p. 175, 2000)
Essa é a ideia aproximada do chamado teste de causalidade de Granger (Granger, p. 424-438, 1969). Mas deve-se observar que a questão da causalidade é profundamente filosófica, com todos os tipos de controvérsias. Em um extremo estão as pessoas que acreditam que “tudo tenha uma causa”, e no outro estão aquelas que negam a existência de causação, seja qual for. O econometrista Edward Leamer prefere o termo precedência a causalidade. Francis Diebold prefere o termo causalidade preditiva. Como ele escreve:
[. . .] a afirmação “ yi causa yj” é uma abreviação da afirmação mais exata, porém mais longa: “yi contém informações úteis para prever yj (no sentido dos mínimos quadrados lineares), acima e além das histórias passadas das outras variáveis no sistema”. Para poupar espaço, dizemos simplesmente que yi causa yj.
A justificativa do uso do teste de causalidade se fundamenta na busca da seguinte resposta para a direção de causa e efeito entre preço do ativo CORN e quantidade transacionada dele próprio:
Se, em um sistema de equações simultâneas que contenha duas ou mais equações, não for possível obter valores numéricos de cada parâmetro em cada equação, porque as equações são empiricamente indistinguíveis, ou muito parecidas, temos o problema da identificação. Sendo assim, na regressão da quantidade Q sobre o preço P, a equação resultante é uma função de demanda ou uma função de oferta (Q e P fazem parte de ambas as funções)? Se tivermos apenas dados sobre Q e P e nenhuma outra informação, será difícil, senão impossível, identificar a regressão como uma função de demanda ou oferta. É fundamental resolvermos o problema da identificação antes de procedermos à estimação, porque, se não sabemos o que estamos estimando, a estimação per se não tem sentido.
Teste de Causalidade de Granger
O teste da causalidade de Granger pressupõe que as informações relevantes à previsão das respectivas variáveis preditivas, (p. ex. duas em duas como PIB e M), estão contidas unicamente nos dados de série temporal dessas variáveis. (Gujarati e Porter, p. 647-653) Em que se supõe que os termos de erro $u_{1t}$ e $u_{2t}$ não estejam correlacionados. A propósito, observe que, uma vez que temos duas variáveis, estamos lidando com a causalidade bilateral. Nas demais séries temporais econométricas, estenderemos isso à causalidade multivariada através da técnica de vetores autorregressivos (VAR).
Uma causalidade unidirecional de M para PIB será indicada se os coeficientes estimados das defasagens de M forem estatisticamente diferentes de zero como grupo e o conjunto de coeficientes estimados do PIB não for estatisticamente diferente de zero.
Por outro lado, a causalidade unidirecional do PIB a M existe se o conjunto de coeficientes defasados não é estatisticamente diferente de zero e o conjunto dos coeficientes do PIB é estatisticamente diferente de zero.
Feedback, ou causalidade bilateral, será sugerido quando os conjuntos de coeficientes de M e PIB forem estatisticamente diferentes de zero em ambas as regressões.
Por fim, a independência será sugerida quando os conjuntos de coeficientes de M e PIB não forem estatisticamente significativos em nenhuma das regressões.
Você pode encontrar um maior detalhamento de modelagem econométrica utilizando Inferência Causal aqui ou então nas literaturas recomendadas
# Os preços (Granger) causam o volume ?

grangertest(CORN[,"CORN.Volume"] ~ CORN[,"CORN.Close"], order=4)
Granger causality test
Model 1: CORN[, "CORN.Volume"] ~ Lags(CORN[, "CORN.Volume"], 1:4) + Lags(CORN[, "CORN.Close"], 1:4)
Model 2: CORN[, "CORN.Volume"] ~ Lags(CORN[, "CORN.Volume"], 1:4)
Res.Df Df F Pr(>F)
1 119
2 123 -4 2.6451 0.03688 *
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1*Existem várias maneiras de encontrar o lag ideal, que vou pular por causa do tempo, mas digamos que quatro seja um número mágico. (hehe)
O valor\(-p\) é altamente significativo, mas e na outra direção ?
# O volume Granger causa os preços ?

grangertest(CORN[,"CORN.Close"] ~ CORN[,"CORN.Volume"], order=4)
Granger causality test
Model 1: CORN[, "CORN.Close"] ~ Lags(CORN[, "CORN.Close"], 1:4) + Lags(CORN[, "CORN.Volume"], 1:4)
Model 2: CORN[, "CORN.Close"] ~ Lags(CORN[, "CORN.Close"], 1:4)
Res.Df Df F Pr(>F)
1 119
2 123 -4 2.9898 0.02157 *
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1Como ele não é significativo, então podemos dizer que conforme o resultado do primeiro teste de causalidade, .os preços Granger causam o volume de negociação do ativo CORN (milho).
O sentido econômico disso se fundamenta na premissa da hipótese de mercados eficientes. Na definição clássica dessa hipótese, Fama (1970) definiu “mercado financeiro eficiente como aquele em que o preço dos ativos negociados sempre reflete inteiramente as informações disponíveis sobre os mesmos.”
O poder dessa Hipótese é significativo, pois a HME descarta a possibilidade de ganhos consistentes com sistemas de negociação que se baseiem apenas nas informações disponíveis. Conforme Shleifer (2000), um investidor médio, seja ele indivíduo, fundo de pensão ou fundo mútuo, não deve esperar superar o mercado consistentemente, e os recursos que tais tipos de investidores utilizam para analisar e negociar ativos são desperdiçados, sendo melhor manter, passivamente, a carteira de mercado, esquecendo a gestão ativa de carteiras. Pode-se afirmar, seguramente, que o campo acadêmico das finanças em geral e, especificamente, o campo de análise e precificação de ativos foi construído com base na HME.
Afirmar, portanto, que um mercado é eficiente em termos de informação significa que não há maneiras de obtenção de lucros anormais mediante o uso da informação, visto que os preços já contemplam essa informação.
"Aqueles que acreditam na hipótese de eficiência do mercado de capital argumentam que os preços das ações são essencialmente aleatórios e, por conseguinte, não há margem para especulação lucrativa no mercado de ações: se fosse possível prever o preço de amanhã com base no preço de hoje, todos seríamos milionários." (Gujarati e Porter, p. 736, 2011)
Esta é apenas a ponta do iceberg, mas deve ser suficiente para despertar sua curiosidade e torná-lo perigoso.
Em termos mais gerais, uma vez que o futuro não pode prever o passado, se a variável X (Granger) causa a variável Y, variações em X deveriam preceder variações em Y. Portanto, em uma regressão de Y sobre outras variáveis (incluindo seus próprios valores passados), se incluirmos os valores passados ou defasados de X e ele aprimorar significativamente a previsão de Y, poderemos dizer que X (Granger) causa Y. Uma definição similar aplica-se se Y (Granger) causa X.
Transformação das séries
Um dos objetivos em finanças é avaliação de riscos de uma carteira de ativos (instrumentos) financeiros. O risco é frequentemente medido em termos de variações de preços dos ativos.
Denotemos por \(P_t\) o preço de um ativo no instante \(t\), normalmente um dia de negócio. Suponha, primeiramente, que não haja dividendos pagos no período. A variação de preços entre os instantes \(t-1\) e \(t\) é dada por \(\Delta P_t = P_t - P_{t-1}\) e a variação relativa de preços ou retorno líquido simples deste ativo entre os mesmos instantes é definido por:
\[ R_t = \displaystyle\frac{P_t-P_{t-1}}{P_t} \] Note que \(R_t = P_t/P_{t-1}\): Chamamos \(1 + R_t = P_t-P_{t-1}\) de retorno bruto simples. Usualmente expressamos \(R_t\) em percentagem, relativamente ao período (um dia, um mês, um ano, etc).É também chamado de taxa de retorno.
Denotando \(pt = log Pt\) (sendo o logaritmo na base \(e\)), definimos o retorno composto continuamente ou simplesmente log-retorno como
\[ r_t = log\frac{P_t}{P_{t-1}} = log(1+R_t) = p_t - p_{t-1} \]
Esta definição será aquela comumemente utilizada e, muitas vezes, \(r_t\) será chamado simplesmente de retorno.
"Na prática é preferivel trabalhar com retornos, que são livres de escala, do que com preços, pois os primeiros têm propriedades estatísticas mais interessantes (como estacionariedade e ergodicidade). Um dos objetivos será, então, modelar retornos. Diversas classes de modelos podem ser utilizadas para esse fim, tais como os modelos ARMA, ARCH, GARCH, modelos de volatilidade estocástica, etc." (Morettin, p. 8, 2006)
Crio uma função que obtém os retornos logarítmicos para um período:
# Função log retornos
ret<-function(x,k=1){
  return(diff(log(x),k))
}

retornos <- ret(CORN[,"CORN.Close"])

retornos_volume <- ret(CORN[,"CORN.Volume"])

serie_retornos <- data.frame(retornos, retornos_volume)

serie_retornos <- ts(serie_retornos, start = decimal_date(as.Date("2010-06-10")), end = decimal_date(as.Date(Sys.Date())), frequency = 365)

# https://stackoverflow.com/questions/31491157/how-do-i-create-daily-time-series-starting-from-a-specific-date/31491208

glimpse(serie_retornos)
Time-Series [1:4007, 1:2] from 2010 to 2021: 0.01288 0.01233 -0.00538 0.01339 -0.00916 ...
- attr(*, "dimnames")=List of 2
..$ : NULL
..$ : chr [1:2] "retornos" "retornos_volume"head(serie_retornos) # Primeiros registros da sérieTime Series:
Start = c(2010, 161)
End = c(2010, 166)
Frequency = 365
retornos retornos_volume
2010.438 0.012878305 0.9162907
2010.441 0.012331562 1.4816045
2010.444 -0.005376434 1.1574528
2010.447 0.013387119 -1.0704414
2010.449 -0.009160369 -0.4054651
2010.452 0.011816376 0.6613985tail(serie_retornos) # Ultimos registros da sérieTime Series:
Start = c(2021, 147)
End = c(2021, 152)
Frequency = 365
retornos retornos_volume
2021.400 0.008832127 0.2225044
2021.403 -0.014353644 -0.3268005
2021.405 0.036246827 0.3545450
2021.408 -0.011636682 -0.5715021
2021.411 -0.020312900 0.3771684
2021.414 0.010359629 0.5204469Note que ao delimitar a data de início da série temporal inclui um dia a mais em função da perda da primeira observação pela transformação em retorno das séries.
Vamos investigar o comportamento das séries de retorno no tempo:
# Gráfico dos retornos do preço e retornos do volume

ggplotly(
  autoplot(ret(CORN[,"CORN.Close"])) # Gráfico dos retornos das cotações de fechamento
      )
ggplotly(
autoplot(ret(CORN[,"CORN.Volume"])) # Gráfico dos retornos do volume de negociação
)ggplotly(
ggsubseriesplot(CORN[, "CORN.Close"]) +
ylab("US$/bushel") +
ggtitle("Seasonal subseries plot: CORN.Close")) # Inspeção do padrão sazonal da série de preçosggplotly(
ggsubseriesplot(CORN[, "CORN.Volume"]) +
ylab("US$/bushel") +
ggtitle("Seasonal subseries plot: CORN.Volume")) # Inspeção do padrão sazonal da série de volumeggplotly(
ggplot(as.data.frame(CORN), aes(x = CORN.Volume, y = CORN.Close))+
geom_point()+
geom_smooth(method = "lm", se = TRUE)+ # Ajusta uma regressao linear simples para demonstrar o relacionamento das variaveis em nível
ggtitle("Ajuste de curva de relacionamento linear entre Preço e Volume"))ggplotly(
ggplot(as.data.frame(CORN), aes(x = CORN.Volume, y = CORN.Close))+
geom_point()+
geom_smooth(method = "lm", se = TRUE)+ # Ajusta uma regressao linear simples para demonstrar o relacionamento das variaveis em nível
ggtitle("Ajuste de curva de relacionamento linear entre Preço e Volume"))GGally::ggpairs(as.data.frame(CORN[,c("CORN.Close","CORN.Volume")])) # Padrões de correlação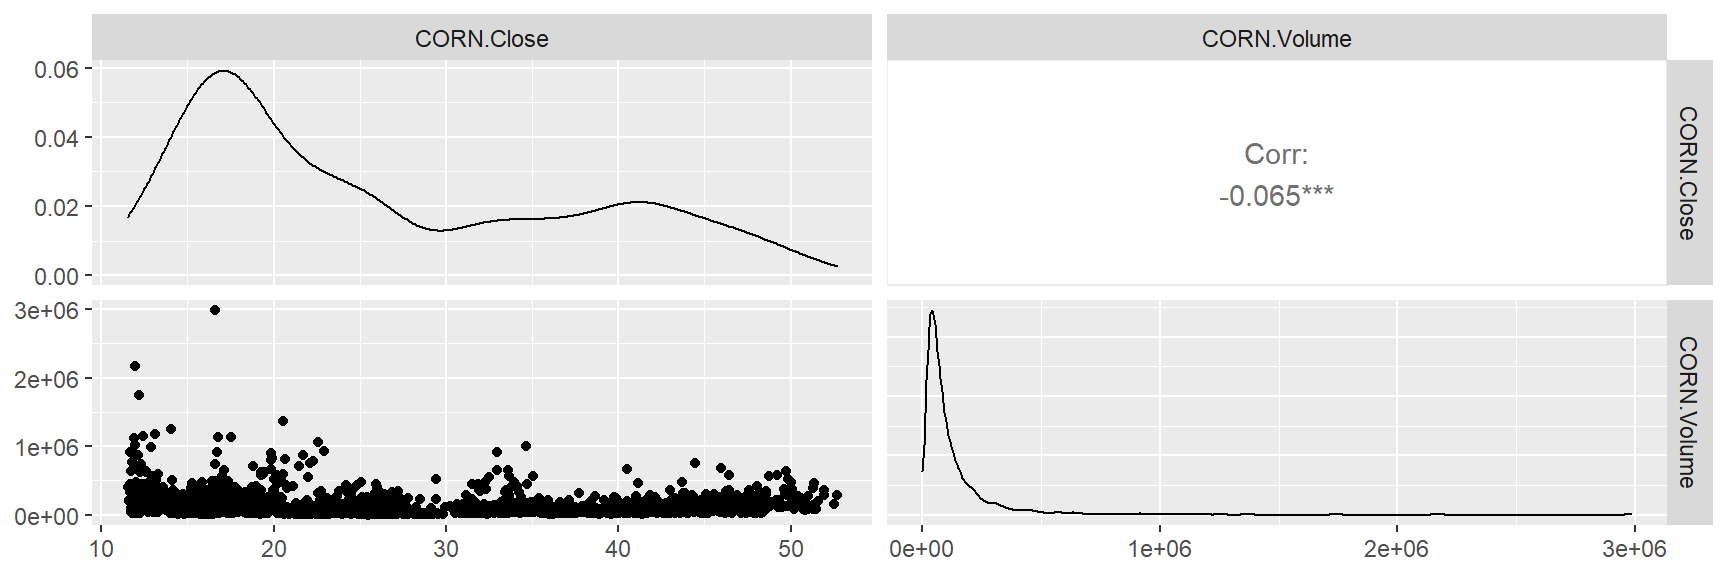
Assim como explicado da necessidade de trabalharmos com retornos que são livres de escala, explicado por Morettin, 2006, de maneira análoga explicam os autores:
"uma vantagem secundária da transformação de primeira diferença é que ela pode tornar estacionária uma série temporal não estacionária." (Gujarati e Porter, p. 352, p. 352)
Padrão de estacionariedade das séries
A autocorrelação pode ser definida como “correlação entre integrantes de séries de observações ordenadas no tempo [como as séries temporais]” ou no espaço [como nos dados de corte transversal]. Convém notar também que a autocorrelação pode ser tanto positiva quanto negativa, embora a maior parte das séries temporais econômicas em geral apresente autocorrelação positiva, pois, em sua maioria, evolui para cima ou para baixo por longos períodos e não apresenta oscilações constantes.
 Fonte: Gujarati e Porter (p. 417, 2006)
Em análise de séries temporais, pois as observações de tais dados seguem um ordenamento natural, de modo que observações sucessivas costumam apresentar intercorrelações, especialmente se o intervalo de tempo entre observações sucessivas for curto, como um dia, uma semana ou um mês, e não um ano. Quando observamos índices de preços de ações, como o Dow Jones ou o S&P 500, durante dias sucessivos, não é raro verificar que esses índices sobem ou descem por vários dias seguidos. Obviamente, em situações como essa, a hipótese de ausência de autocorrelação ou ausência de correlação serial nos termos de erro que embasa o modelo clássico de regressão linear não será respeitada.
 # Funções de autocorrelação
ggplotly(
  ggAcf(CORN[,"CORN.Close"])
)
ggplotly(
ggAcf(CORN[, "CORN.Volume"])
)Testes de raiz unitária a integração das séries
Algumas vezes, a autocorrelação ocorre, porque a série temporal subjacente é não estacionária.
De maneira contrária, ma série temporal é estacionária se suas características (por exemplo, a média, variância e covariância) não variam ao longo do tempo.
adf.test(CORN[,"CORN.Close"]) # Dickey-Fuller Ampliado para fechamento
    Augmented Dickey-Fuller Test

data:  CORN[, "CORN.Close"]
Dickey-Fuller = -2.4375, Lag order = 5, p-value = 0.3946
alternative hypothesis: stationary
adf.test(CORN[,"CORN.Volume"]) # Dickey-Fuller Ampliado para volume
    Augmented Dickey-Fuller Test

data:  CORN[, "CORN.Volume"]
Dickey-Fuller = -2.2497, Lag order = 5, p-value = 0.4727
alternative hypothesis: stationary
Acf(CORN[,"CORN.Close"]) # Função de autocorrelação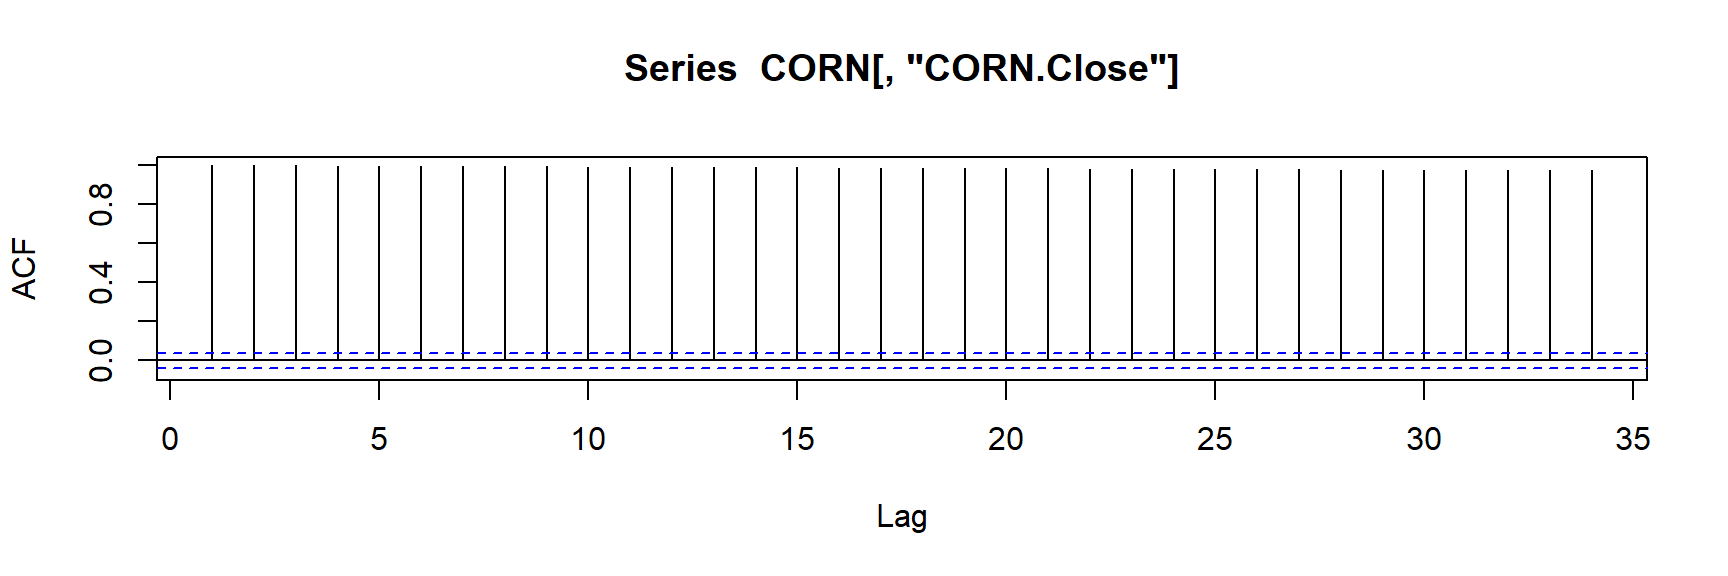
pacf(CORN[,"CORN.Close"]) # Função de autocorrelação parcial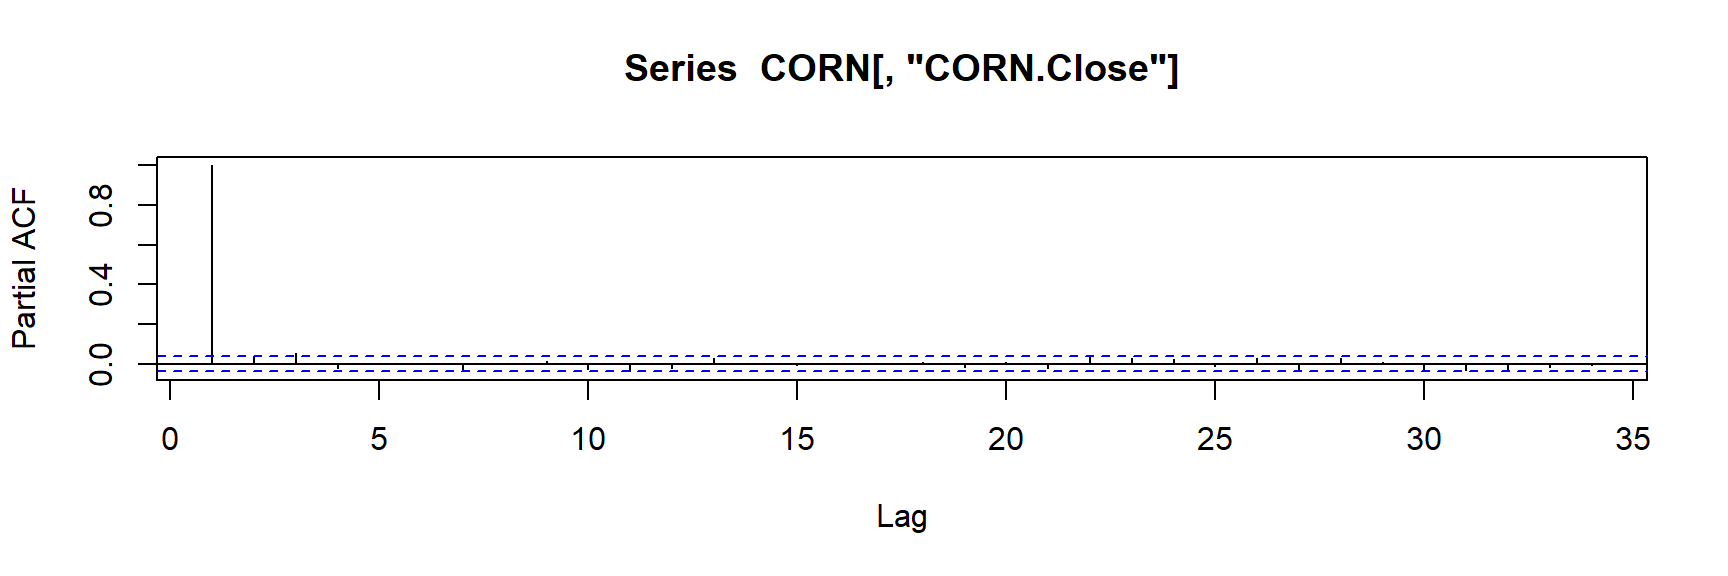
Acf(diff(CORN[,"CORN.Close"])) # Função de autocorrelação na primeira diferença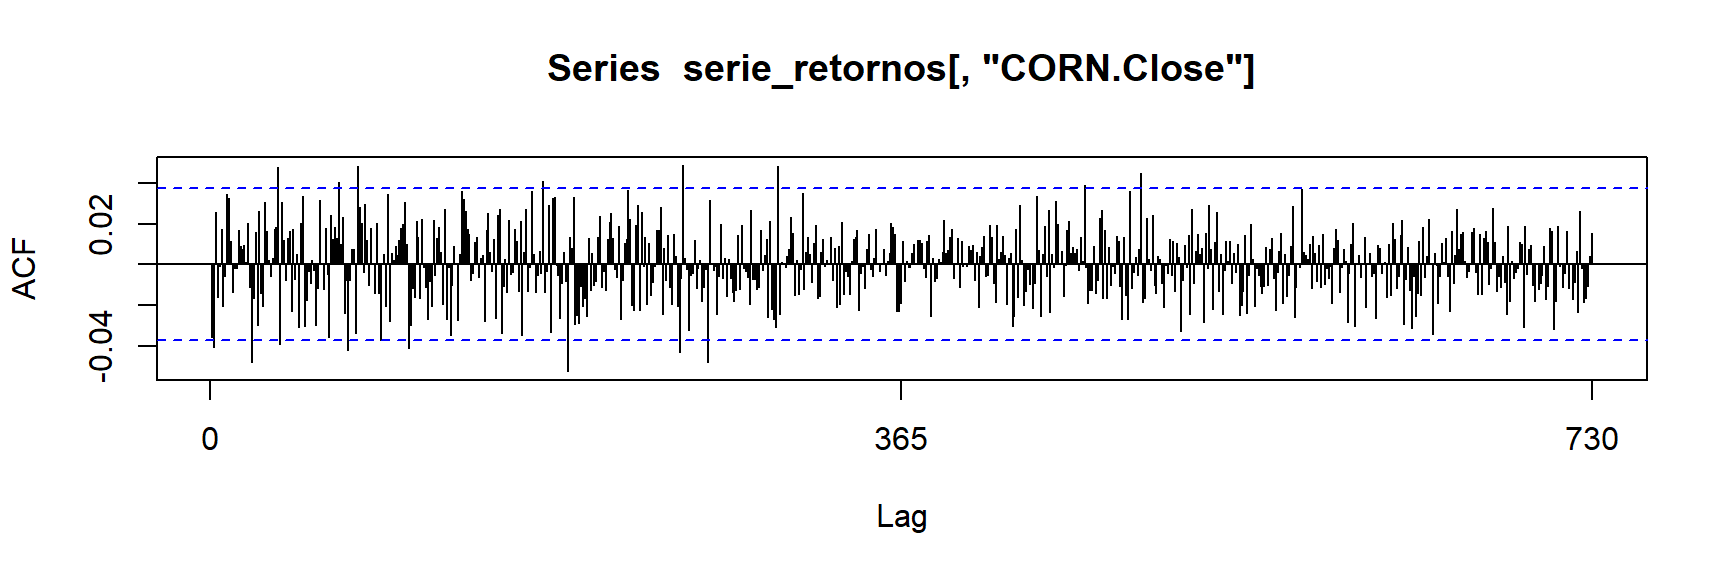
pacf(diff(CORN[,"CORN.Close"])) # Função de autocorrelação parcial na primeira diferença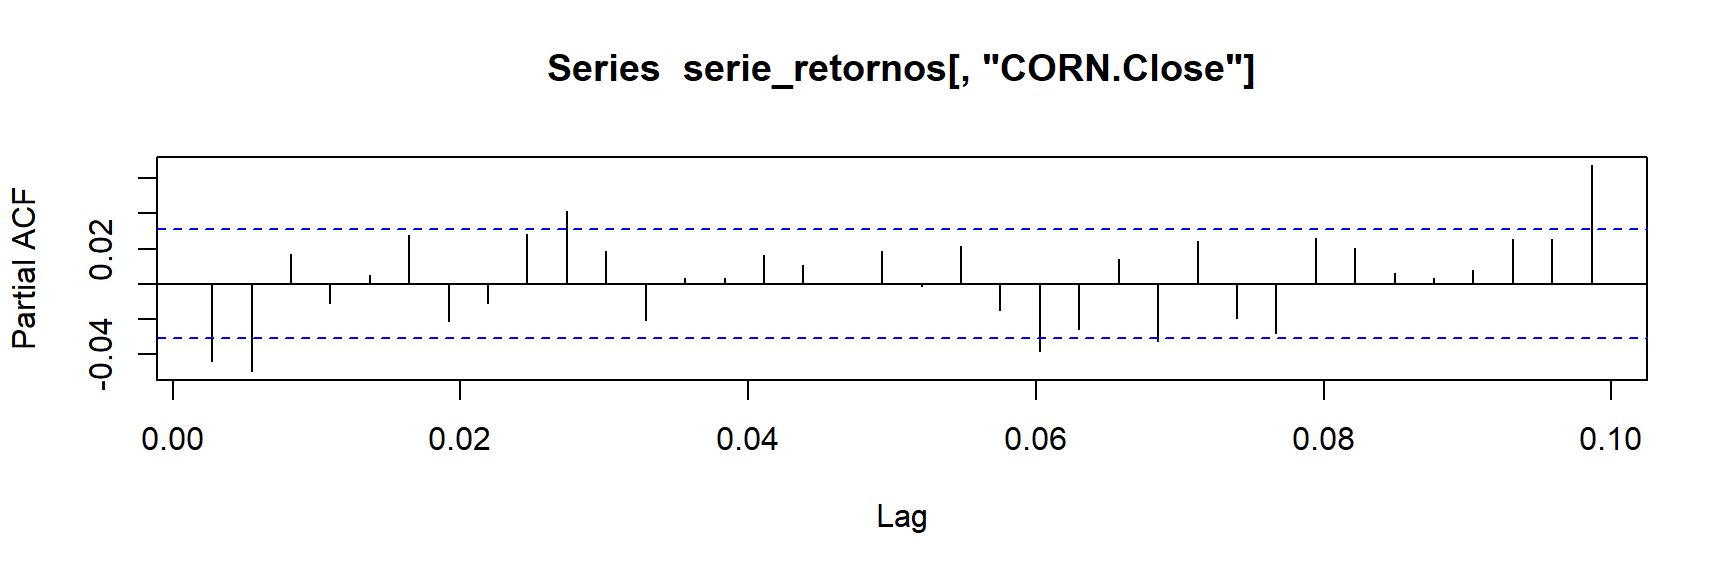
Acf(CORN[,"CORN.Volume"]) # Função de autocorrelação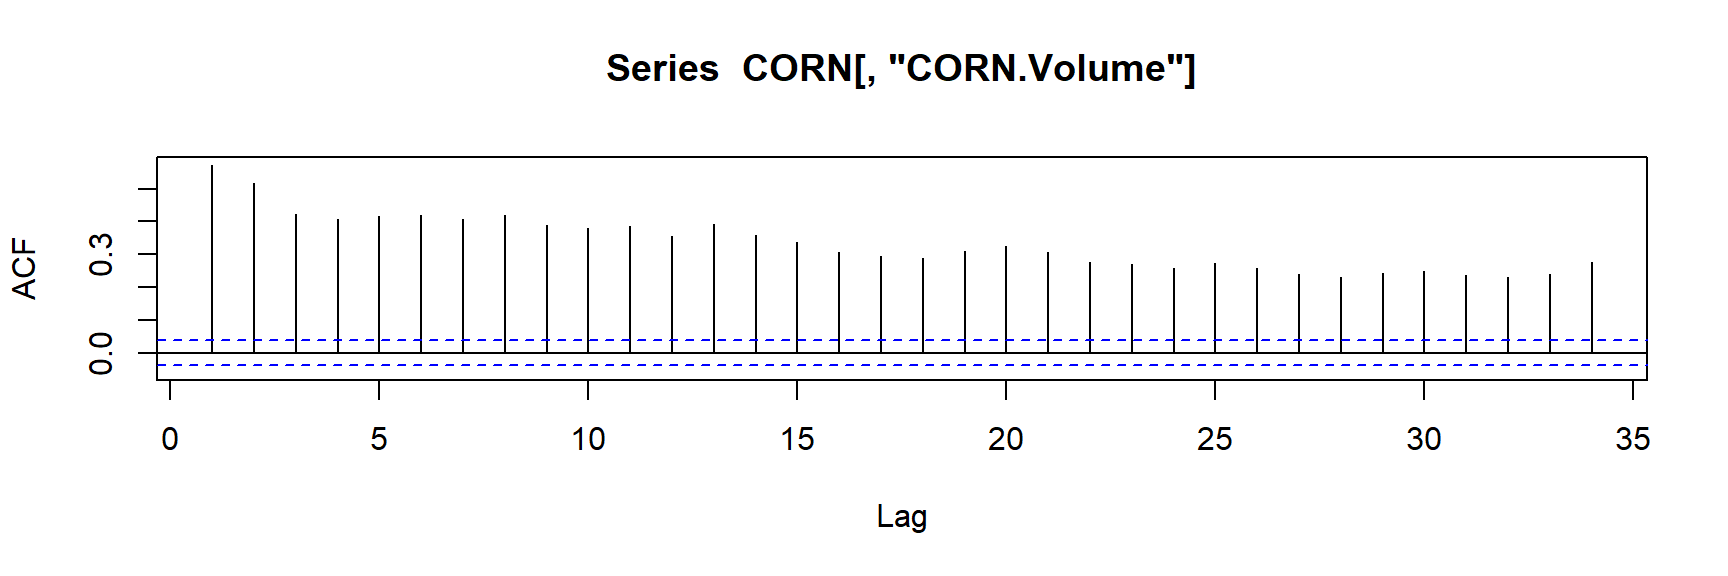
pacf(CORN[,"CORN.Volume"]) # Função de autocorrelação parcial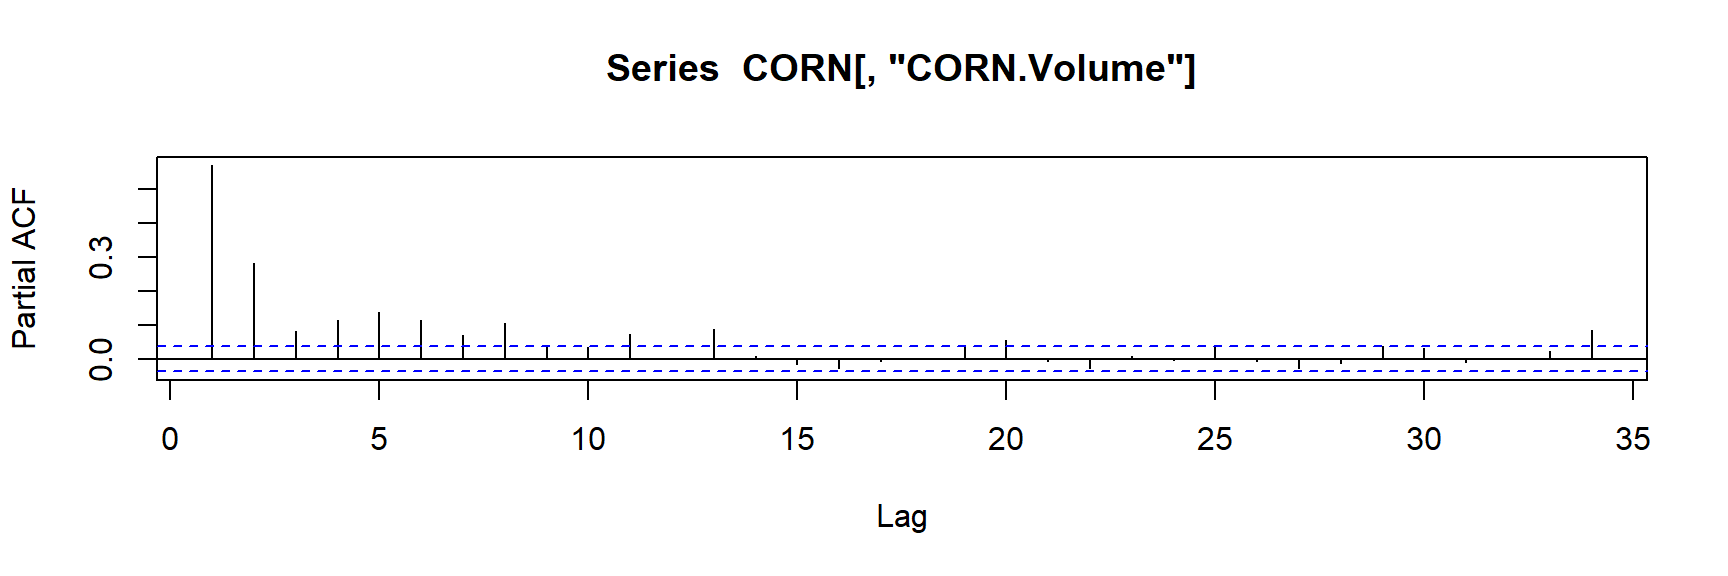
Acf(diff(CORN[,"CORN.Volume"])) # Função de autocorrelação na primeira diferença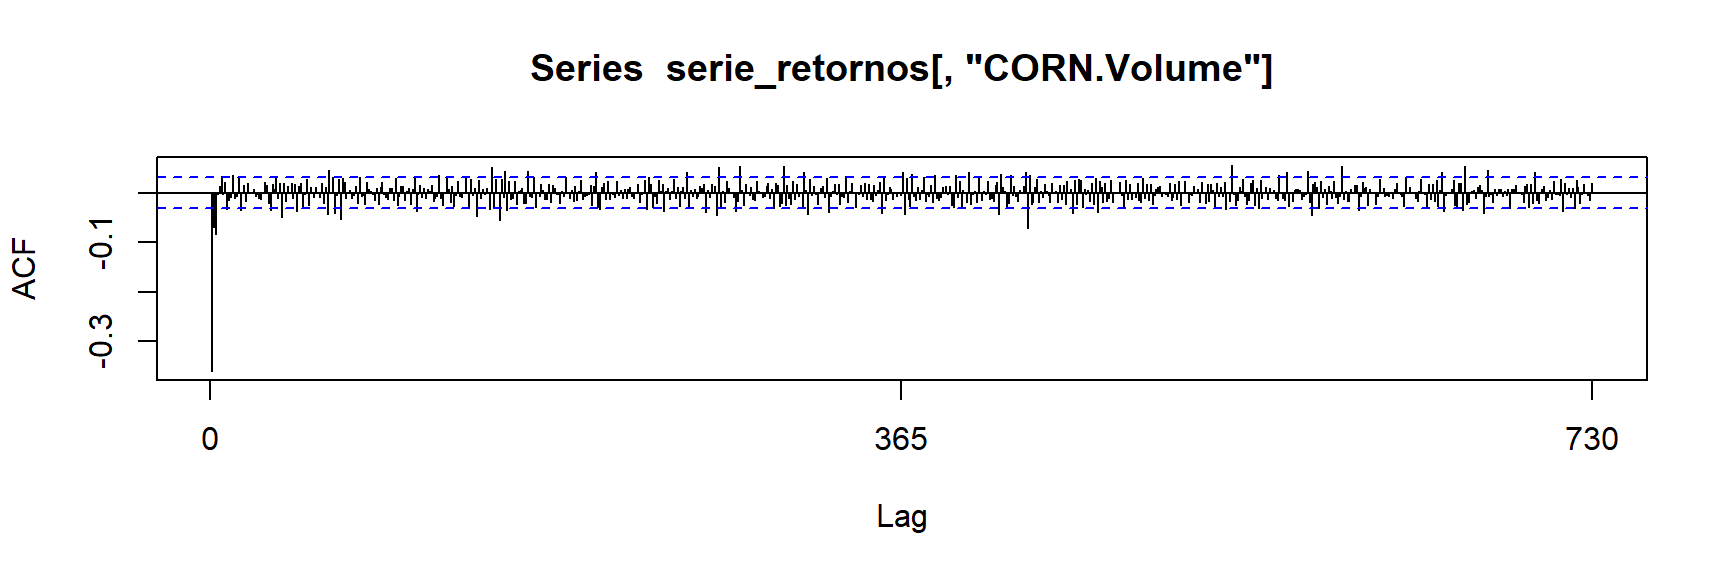
pacf(diff(CORN[,"CORN.Volume"])) # Função de autocorrelação parcial na primeira diferença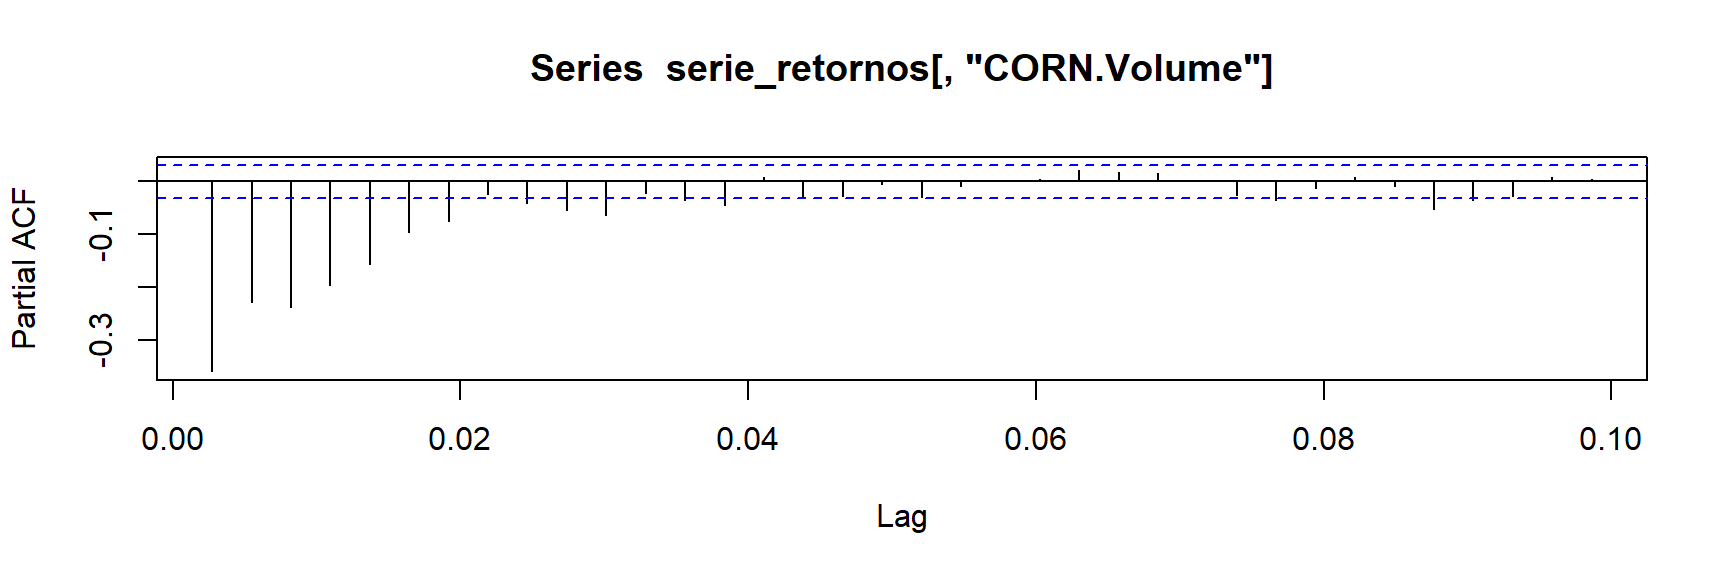
Teste Dickey-Fuller Ampliado para séries em primeiras diferenças
adf.test(diff(CORN[,"CORN.Close"]))
    Augmented Dickey-Fuller Test

data:  diff(CORN[, "CORN.Close"])
Dickey-Fuller = -4.7248, Lag order = 5, p-value = 0.01
alternative hypothesis: stationary
adf.test(diff(CORN[,"CORN.Volume"]))
    Augmented Dickey-Fuller Test

data:  diff(CORN[, "CORN.Volume"])
Dickey-Fuller = -8.0954, Lag order = 5, p-value = 0.01
alternative hypothesis: stationary
A saída do adf.test inclui um valor \(p\). Convencionalmente, se \(p <0,05\), a série temporal provavelmente está se revertendo à média, enquanto que se \(p> 0,05\) não fornece tal evidência.
De modo similar, testamos o processo de reversão à média se evidente nas séries:
pp.test(CORN[,"CORN.Close"], type = "Z(t_alpha)") # Phillips-Perron em nível
    Phillips-Perron Unit Root Test

data:  CORN[, "CORN.Close"]
Dickey-Fuller Z(t_alpha) = -2.7704, Truncation lag parameter = 4,
p-value = 0.2561
alternative hypothesis: stationary
pp.test(CORN[,"CORN.Volume"], type = "Z(t_alpha)")
    Phillips-Perron Unit Root Test

data:  CORN[, "CORN.Volume"]
Dickey-Fuller Z(t_alpha) = -8.4021, Truncation lag parameter = 4,
p-value = 0.01
alternative hypothesis: stationary
pp.test(diff(CORN[,"CORN.Close"]), type = "Z(t_alpha)")# PP em primeira diferencas
    Phillips-Perron Unit Root Test

data:  diff(CORN[, "CORN.Close"])
Dickey-Fuller Z(t_alpha) = -13.88, Truncation lag parameter = 4,
p-value = 0.01
alternative hypothesis: stationary
pp.test(diff(CORN[,"CORN.Volume"]), type = "Z(t_alpha)")
    Phillips-Perron Unit Root Test

data:  diff(CORN[, "CORN.Volume"])
Dickey-Fuller Z(t_alpha) = -23.035, Truncation lag parameter = 4,
p-value = 0.01
alternative hypothesis: stationary
Em resumo, se uma série temporal for estacionária, a média, variância e autocovariâncias (em variadas defasagens) permanecerão as mesmas não importa em que ponto a mensuremos; isto é, elas serão invariantes no tempo. Tal série temporal tenderá a retornar para a sua média (o que chamamos de reversão da média), e flutuações em torno dessa média (mensurada por sua variância) terão, de modo geral, uma amplitude constante. Em outras palavras, um processo estacionário não se desviará muito de seu valor médio em virtude da variância finita. Como veremos em breve, esse não é o caso do processo estocástico não estacionário. Devemos observar que, para o processo estacionário, a velocidade da reversão à média depende das autocovariâncias; isso será rápido, se as autocovariâncias forem pequenas, e lento quando são grandes. (Gujarati e Porter, p. 735, 2011)
Teste de estacionariedade
kpss.test(CORN[,"CORN.Close"]) # Teste KPSS em nivel
    KPSS Test for Level Stationarity

data:  CORN[, "CORN.Close"]
KPSS Level = 2.5574, Truncation lag parameter = 4, p-value = 0.01
kpss.test(CORN[,"CORN.Volume"])
    KPSS Test for Level Stationarity

data:  CORN[, "CORN.Volume"]
KPSS Level = 1.473, Truncation lag parameter = 4, p-value = 0.01
kpss.test(diff(CORN[,"CORN.Close"])) # Teste KPSS em primeira diferenca
    KPSS Test for Level Stationarity

data:  diff(CORN[, "CORN.Close"])
KPSS Level = 0.053852, Truncation lag parameter = 4, p-value = 0.1
ggAcf(diff(CORN[,"CORN.Close"])) # Função de autocorrelação em primeira diferenca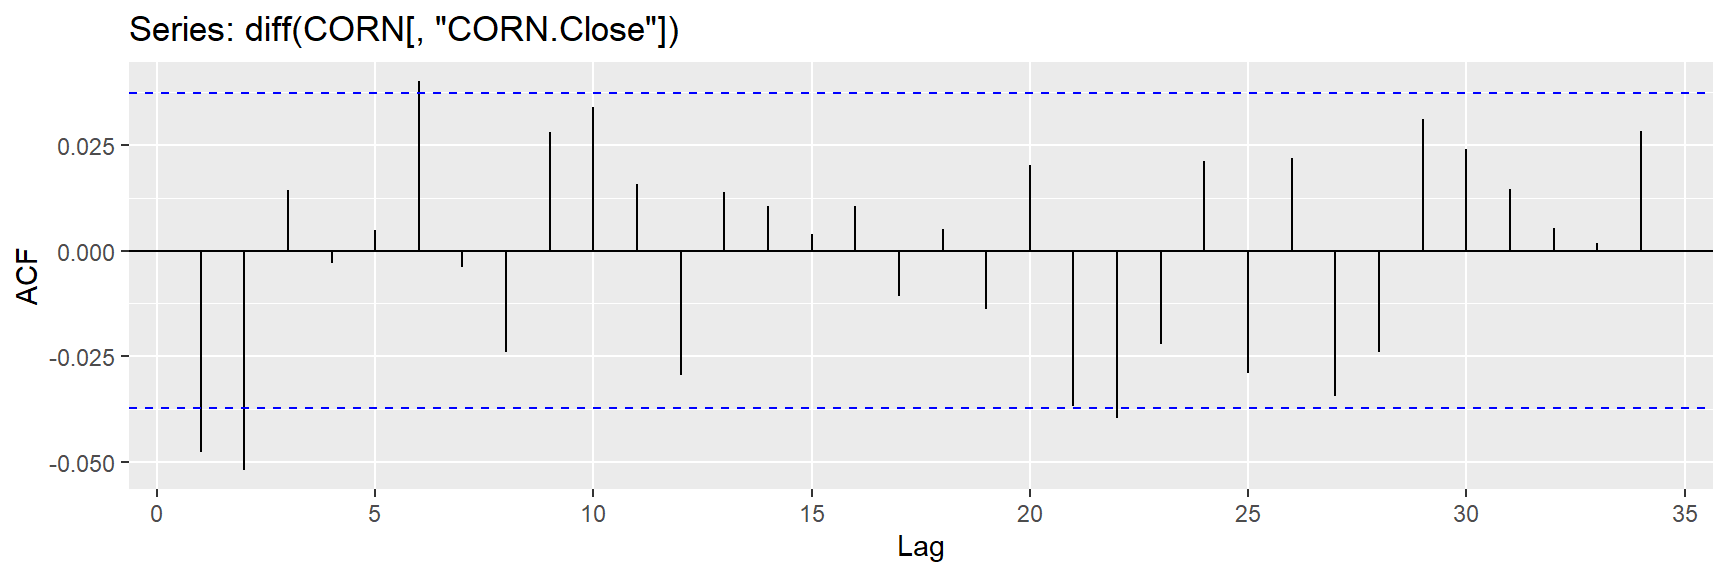
kpss.test(diff(CORN[,"CORN.Volume"]))
    KPSS Test for Level Stationarity

data:  diff(CORN[, "CORN.Volume"])
KPSS Level = 0.026445, Truncation lag parameter = 4, p-value = 0.1
ggAcf(diff(CORN[,"CORN.Volume"])) 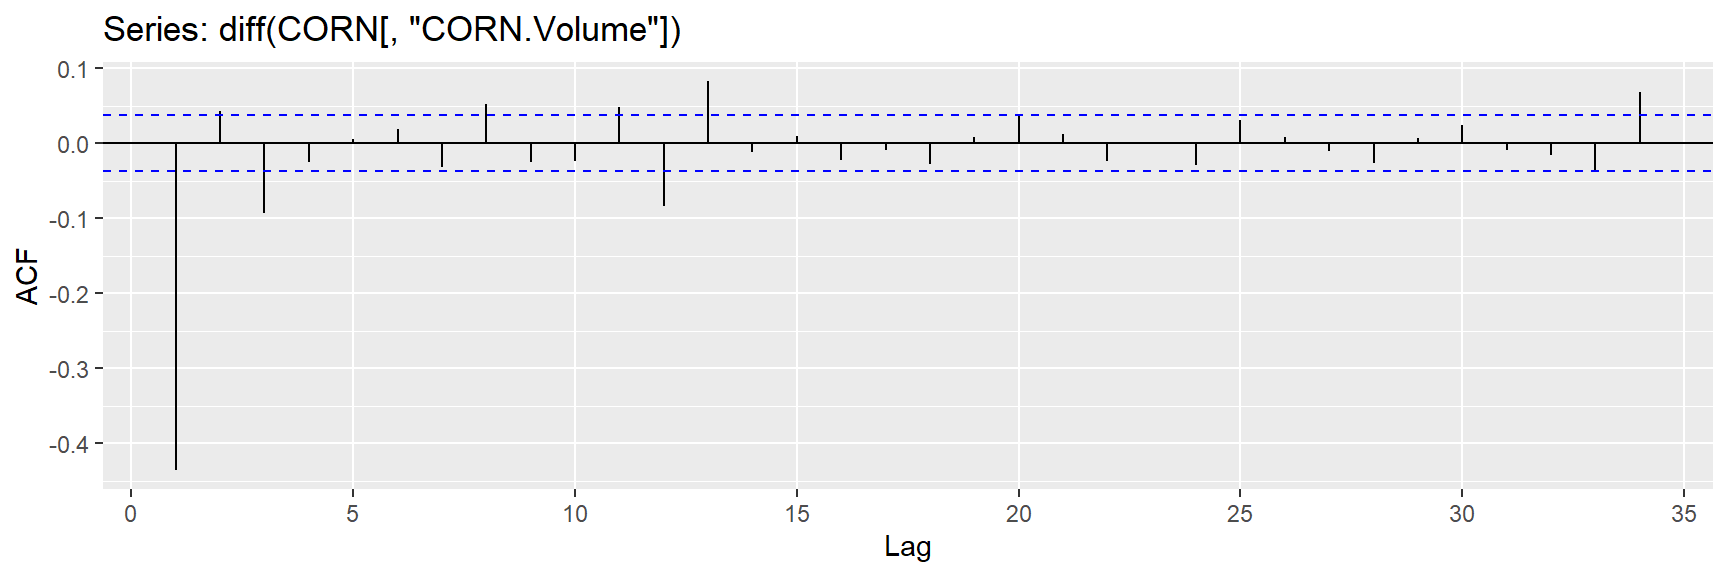
Portanto, o teste KPSS também aponta para a não estacionariedade da série de preços e de volume. (Novamente, um aviso é emitido, pois o valor \(p\) é interpolado dos quatro valores críticos fornecidos por Kwiatkowski et al. 1992, ele é suprimido aqui.)
Box.test(CORN[,"CORN.Close"], lag = 24, fitdf = 0, type = "Lj")
    Box-Ljung test

data:  CORN[, "CORN.Close"]
X-squared = 1958.6, df = 24, p-value < 2.2e-16
Box.test(CORN[,"CORN.Volume"], lag = 24, fitdf = 0, type = "Lj")
    Box-Ljung test

data:  CORN[, "CORN.Volume"]
X-squared = 263.07, df = 24, p-value < 2.2e-16
um valor \(p\) maior que 0,05 sugere que os dados não são significativamente diferentes do ruído branco. (ou seja, se o valor\(-p\) da Ljung-Box for maior que 0,05 ou 5% temos uma série do tipo ruído branco)
Testaremos a correlação entre volume e preço do ativo CORN
Ccf(diff(CORN[,"CORN.Close"]), diff(CORN[,"CORN.Volume"]), main = "Fechamento vs. Volume")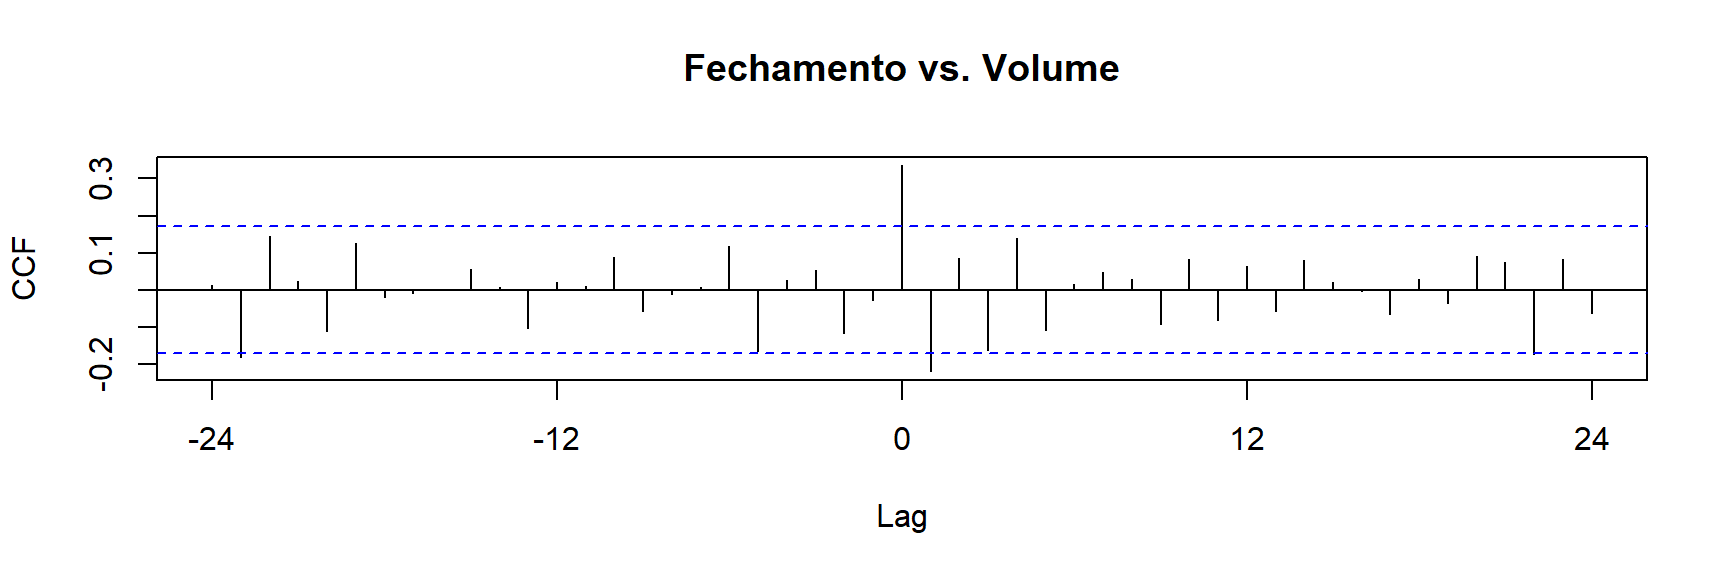
Cada linha vertical mostra a correlação entre as duas séries temporais em algum atraso, conforme indicado ao longo do eixo x. Se uma correlação se estender acima ou abaixo das linhas pontilhadas, ela é estatisticamente significativa.
Observe que a correlação no lag 12 é de aproximadamente –0,11, que é a correlação simples entre as variáveis. Evidentemente, há algum “efeito cascata” no volume do dia-a-dia e no preço das commodities porque as mudanças hoje estão correlacionadas com as mudanças amanhã. Descobrir esse tipo de relacionamento é útil para analistas de curto prazo, como analistas de mercado, traders e corretores de títulos, p. ex.
Avaliação da presença de cointegração entre volume e preço
A própria natureza das duas séries já sugere que elas possuem características comuns. Tendo evidência de não estacionariedade, é interessante testar um componente não estacionário comum por meio de um teste de cointegração. Um método simples para testar a cointegração é o método de duas etapas proposto por Engle e Granger (1987). Ele faz a regressão de uma série na outra e executa um teste de raiz unitária nos resíduos. Este teste, muitas vezes nomeado após Phillips e Ouliaris (1990), que forneceram a teoria assintótica, está disponível na função po.test() do pacote tseries.
po.test(log(CORN[,5:6]))
    Phillips-Ouliaris Cointegration Test

data:  log(CORN[, 5:6])
Phillips-Ouliaris demeaned = -31.213, Truncation lag parameter = 1,
p-value = 0.01
Como esperadamente, o resultado do teste demonstra que a cointegração das séries em nível (logarítmico) não se fez presente.
Os testes padrão que procedem de maneira simétrica derivam da abordagem de máxima verossimilhança de informações completas de Johansen (Johansen, 1991). Para um modelo de vetor autorregressivo (VAR) cointegrado de ordem \(p\), a forma de correção de erro é (omitindo componentes determinísticos)
Os testes relevantes estão disponíveis na função ca.jo() do pacote urca. Vide p. ex. Hamilton (1994) para o background metodológico. Aqui, empregamos a estatística de rastreamento - o teste de autovalor máximo, ou “lambdamax”, também está disponível - em uma equação corrigida por um termo constante (especificado por ecdet = "const"), resultando
library(urca)
teste_jj <- ca.jo(log(CORN[,5:6]), ecdet = "const", type = "trace")
summary(teste_jj)
######################
# Johansen-Procedure #
######################

Test type: trace statistic , without linear trend and constant in cointegration

Eigenvalues (lambda):
[1]  2.818562e-01  2.734383e-02 -2.725306e-17

Values of teststatistic and critical values of test:

          test 10pct  5pct  1pct
r <= 1 |  3.60  7.52  9.24 12.97
r = 0  | 46.65 17.85 19.96 24.60

Eigenvectors, normalised to first column:
(These are the cointegration relations)

               CORN.Close.l2 CORN.Volume.l2   constant
CORN.Close.l2       1.000000     1.00000000  1.0000000
CORN.Volume.l2     -0.187067    -0.03452543 -0.0139828
constant           -1.535347    -3.26080512 -3.2186117

Weights W:
(This is the loading matrix)

              CORN.Close.l2 CORN.Volume.l2      constant
CORN.Close.d     0.01315698    -0.01779948 -1.022896e-15
CORN.Volume.d    3.47537873    -0.02324695  3.088515e-13
Todavia, a hipótese nula de nenhuma cointegração é rejeitada; portanto, o teste de Johansen confirma os resultados da abordagem inicial em duas etapas.
Teste de Quebra Estrutural
O teste de mudança estrutural associado, por padrão considerando o desvio máximo absoluto do processo de flutuação empírica em torno de zero é tido como significativo no nível padrão de 5%, sinalizando que os parâmetros do modelo não são estáveis ao longo de todo o período da amostra.
library(strucchange)

dd_ocus <- efp(log(CORN[,"CORN.Close"]) ~ log(CORN[, "CORN.Volume"]), data = CORN, type = "OLS-CUSUM")
sctest(dd_ocus)
    OLS-based CUSUM test

data:  dd_ocus
S0 = 3.5881, p-value = 1.313e-11
plot(dd_ocus)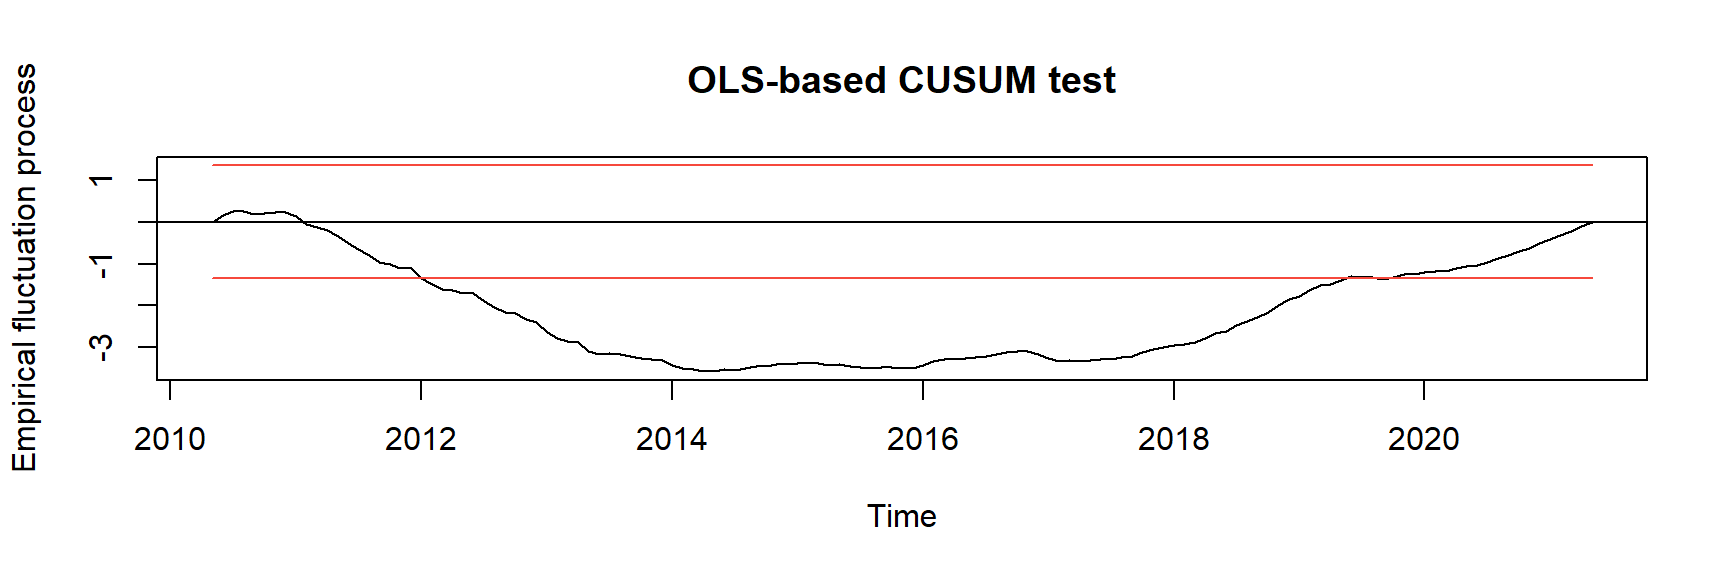
Testes baseados em estatísticas \(F\), a segunda classe de testes em mudança estrutural, são projetados para ter boa potência para alternativas de quebra única (de tempo desconhecido). A ideia básica é calcular uma estatística \(F\) (ou estatística/teste Chow) para cada ponto de interrupção/quebra concebível em um determinado intervalo e rejeitar a hipótese nula de estabilidade estrutural se alguma dessas estatísticas (ou algum outro funcional, como a média) exceder um certo valor crítico (Andrews 1993; Andrews e Ploberger 1994). Processos de estatísticas \(F\) podem ser ajustados com Fstats(), empregando uma interface semelhante a efp(). Os objetos “Fstats” resultantes podem ser avaliados novamente pelo método sctest() correspondente ou graficamente pelo método plot(). O pedaço de código
dd_fs <- Fstats(log(CORN[,"CORN.Close"]) ~ log(CORN[, "CORN.Volume"]), data = CORN, from = 0.1)
plot(dd_fs)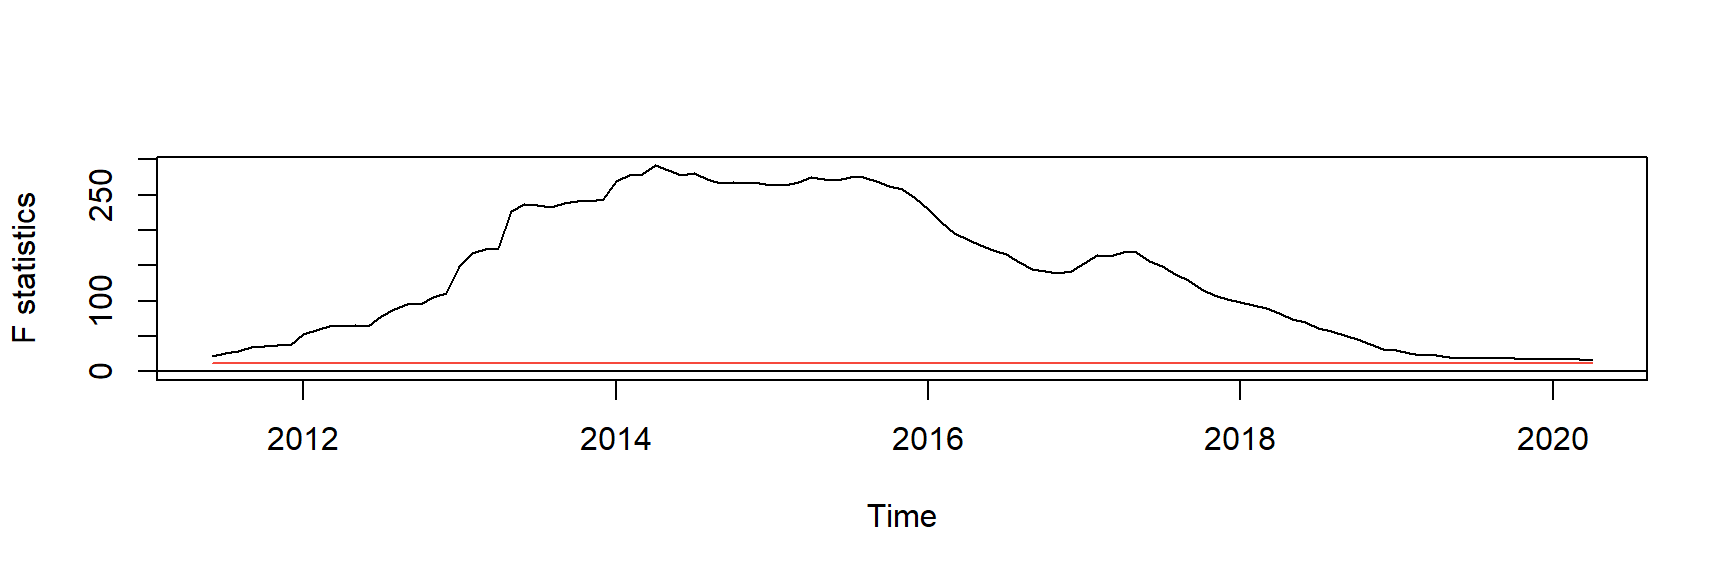
sctest(dd_fs)
    supF test

data:  dd_fs
sup.F = 291.53, p-value < 2.2e-16
Portanto, não rejeitaremos a hipótese nula de estabilidade dos parâmetros (ausência de mudança estrutural) se o valor de \(F\) calculado em uma aplicação não for superior ao valor de \(F\) crítico registrado na tabela F no nível de significância (ou valor \(p\)) escolhido.
Modelo Dating Structural Changes
Voltando à série CORN, estimamos os pontos de interrupção para um modelo do tipo SARIMA com um tamanho mínimo de segmento de 10% usando,
dd_bp <- breakpoints(log(CORN[,"CORN.Close"]) ~ log(CORN[, "CORN.Volume"]), data = CORN, h = 0.1)
plot(dd_bp)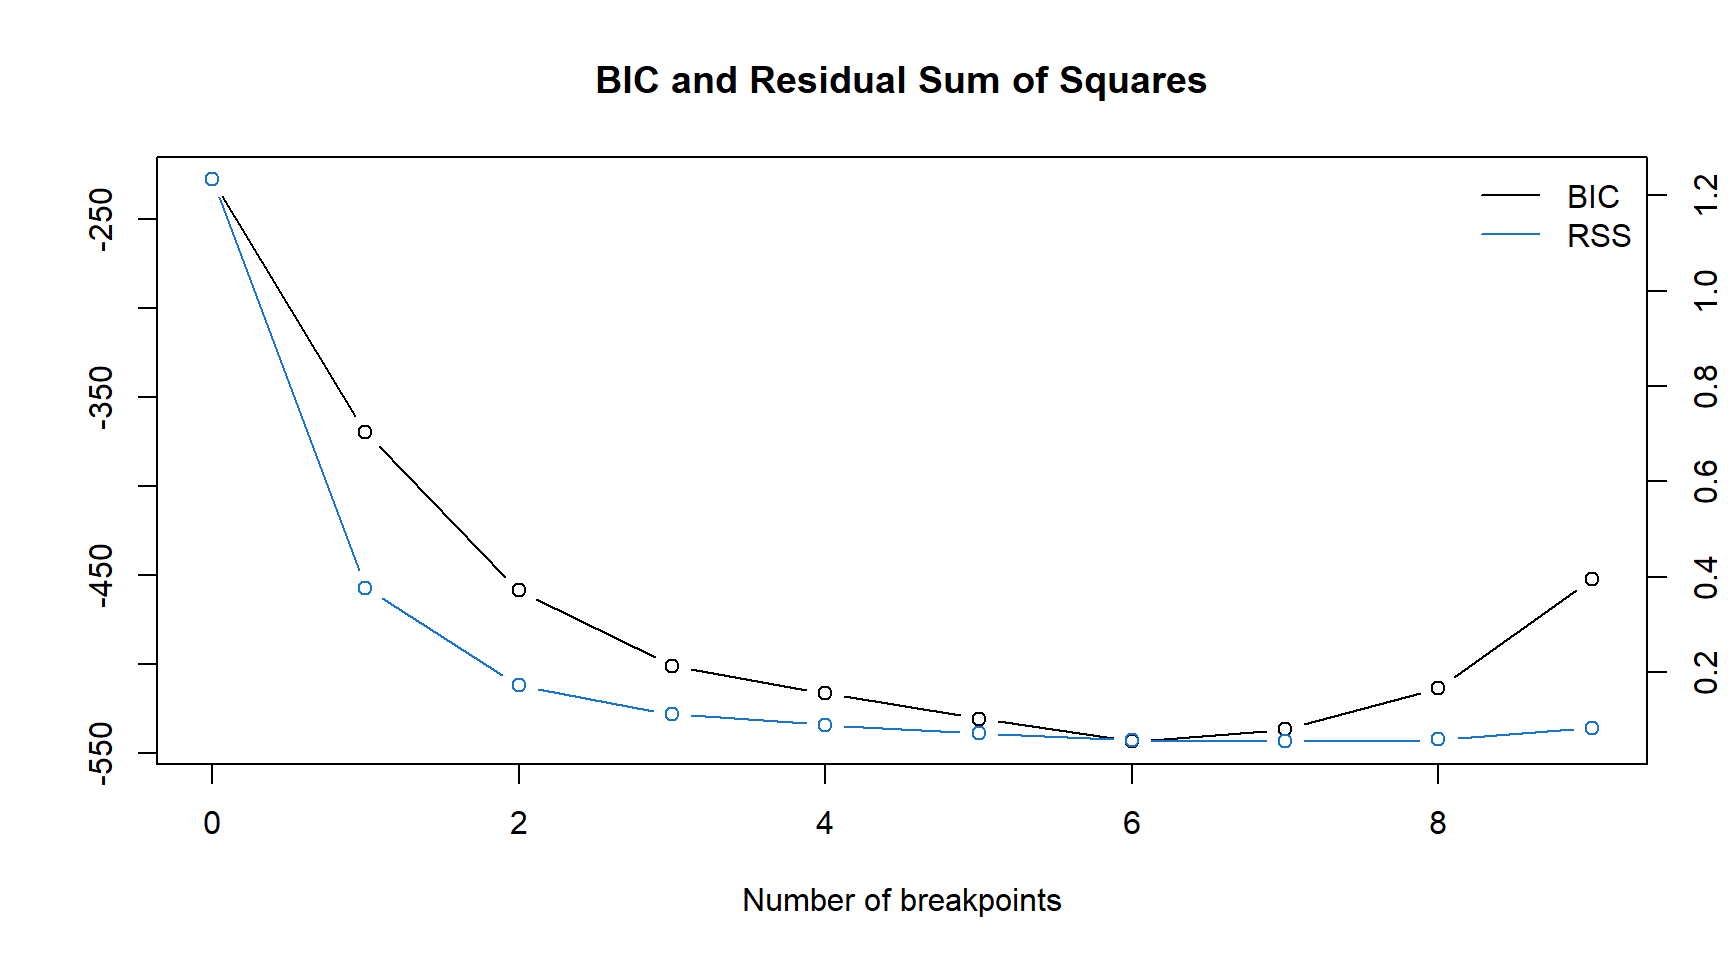
O RSS e o BIC conforme exibidos pelo gráfico (dd_bp) são mostrados a seguir. Embora o RSS caia claramente até m = 3 quebras, o BIC é mínimo para m = 0 quebras. Isso não é muito satisfatório, pois os testes de mudança estrutural mostraram claramente que os parâmetros do modelo não são estáveis. Como o BIC foi considerado pouco confiável para modelos autorregressivos por Bai e Perron (2003), contamos com a interpretação da visualização dos testes de mudança estrutural e usamos o modelo com m = 2 quebras. Seus coeficientes podem ser extraídos via
coef(dd_bp, breaks = 2) (Intercept) log(CORN[, "CORN.Volume"])
2010(6) - 2014(4) 3.185281 0.0109253344
2014(5) - 2017(5) 2.991984 0.0444446952
2017(6) - 2021(5) 3.584637 0.0001064469As séries observadas e ajustadas, juntamente com os intervalos de confiança para os pontos de quebra, são mostradas a seguir conforme gerado por
plot(log(CORN[,"CORN.Close"]))
lines(fitted(dd_bp, breaks = 2), col = 4)
lines(confint(dd_bp, breaks = 2))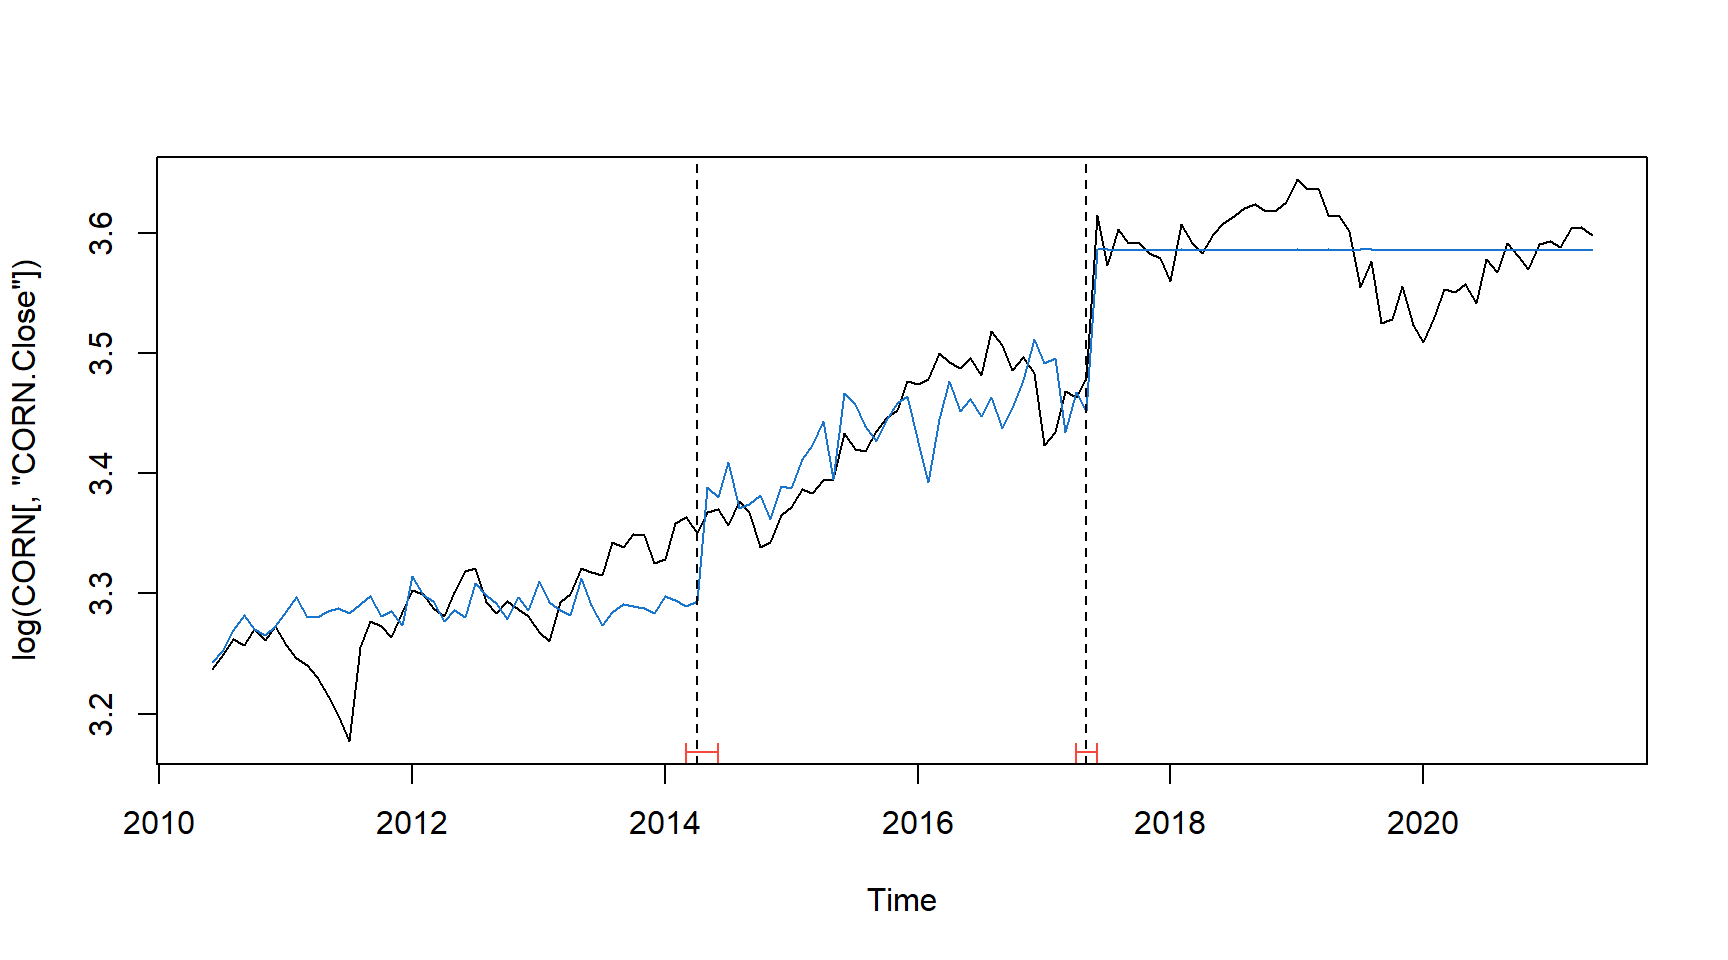
Características das Séries Temporais
Além das características especificadas anteriormente como fatos estilizados a respeito das séries temporais financeiras, descritas por Morettin (2006) anteriomente, destacamos alguns aspectos comuns na teoria de análise de séries temporais:
Tendência
Existe uma tendência quando há um aumento ou diminuição de longo prazo nos dados. Isto não precisa ser linear. Às vezes, nos referiremos a uma tendência como “mudança direção”, quando pode passar de uma tendência crescente para uma tendência decrescente.
Sazonalidade
Já um padrão sazonal ocorre quando uma série temporal é afetada por fatores sazonais como a época do ano ou o dia da semana. A sazonalidade é sempre de uma frequência fixa e conhecida. Muitas séries temporais baseadas em dados mensais ou trimestrais exibem padrões sazonais (movimentos oscilatórios regulares). Exemplos são as vendas de lojas de departamentos no Natal ou em outros dias importantes, a demanda por dinheiro (ou saldos) pelas famílias em datas comemorativas, a demanda de sorvete e refrigerantes durante o verão, preços das safras logo depois da temporada de colheita, a demanda por viagens aéreas etc. Com frequência, é desejável remover o fator sazonal, ou componente, de uma série temporal de modo que se possa concentrar nos demais componentes, como a tendência. O processo de remover o componente sazonal de uma série temporal é conhecido como dessazonalização ou ajustamento sazonal, e a série temporal assim obtida é chamada série temporal dessazonalizada, ou ajustada sazonalmente.
Cíclico
Um ciclo ocorre quando a exibição de dados sobe e desce que não são fixos frequência. Essas flutuações são geralmente devido às condições econômicas, e estão freqüentemente relacionados ao “ciclo de negócios”. A duração dessas flutuações geralmente é de pelo menos 2 anos.
Muitas pessoas confundem comportamento cíclico com comportamento sazonal, mas eles são realmente muito diferente. Se as flutuações não são de frequência fixa, então eles são cíclicos; se a frequência é imutável e associada a algum aspecto do calendário, então o padrão é sazonal. Em geral, a duração média dos ciclos é mais longo do que a duração de um padrão sazonal, e as magnitudes dos ciclos tendem ser mais variável do que as magnitudes dos padrões sazonais.
Muitas séries temporais incluem tendência, ciclos e sazonalidade. Ao escolher um método de previsão, primeiro precisamos identificar os padrões de série temporal no dados e, em seguida, escolha um método que seja capaz de capturar os padrões de maneira adequada.
Análise da Estrutura da Série Temporal
Os modelos de estrutura de séries temporais são modelos de espaço de estado que utilizam uma decomposição da série temporal em uma série de componentes que são especificados por um conjunto de variações de perturbação. Assim, esses modelos podem ser considerados modelos de componentes de erro para dados de séries temporais. Harvey (1989) e Durbin e Koopman (2001) são referências padrão.
dd_struct_Close <- StructTS(log(CORN[,"CORN.Close"]))

plot(cbind(fitted(dd_struct_Close), residuals(dd_struct_Close)))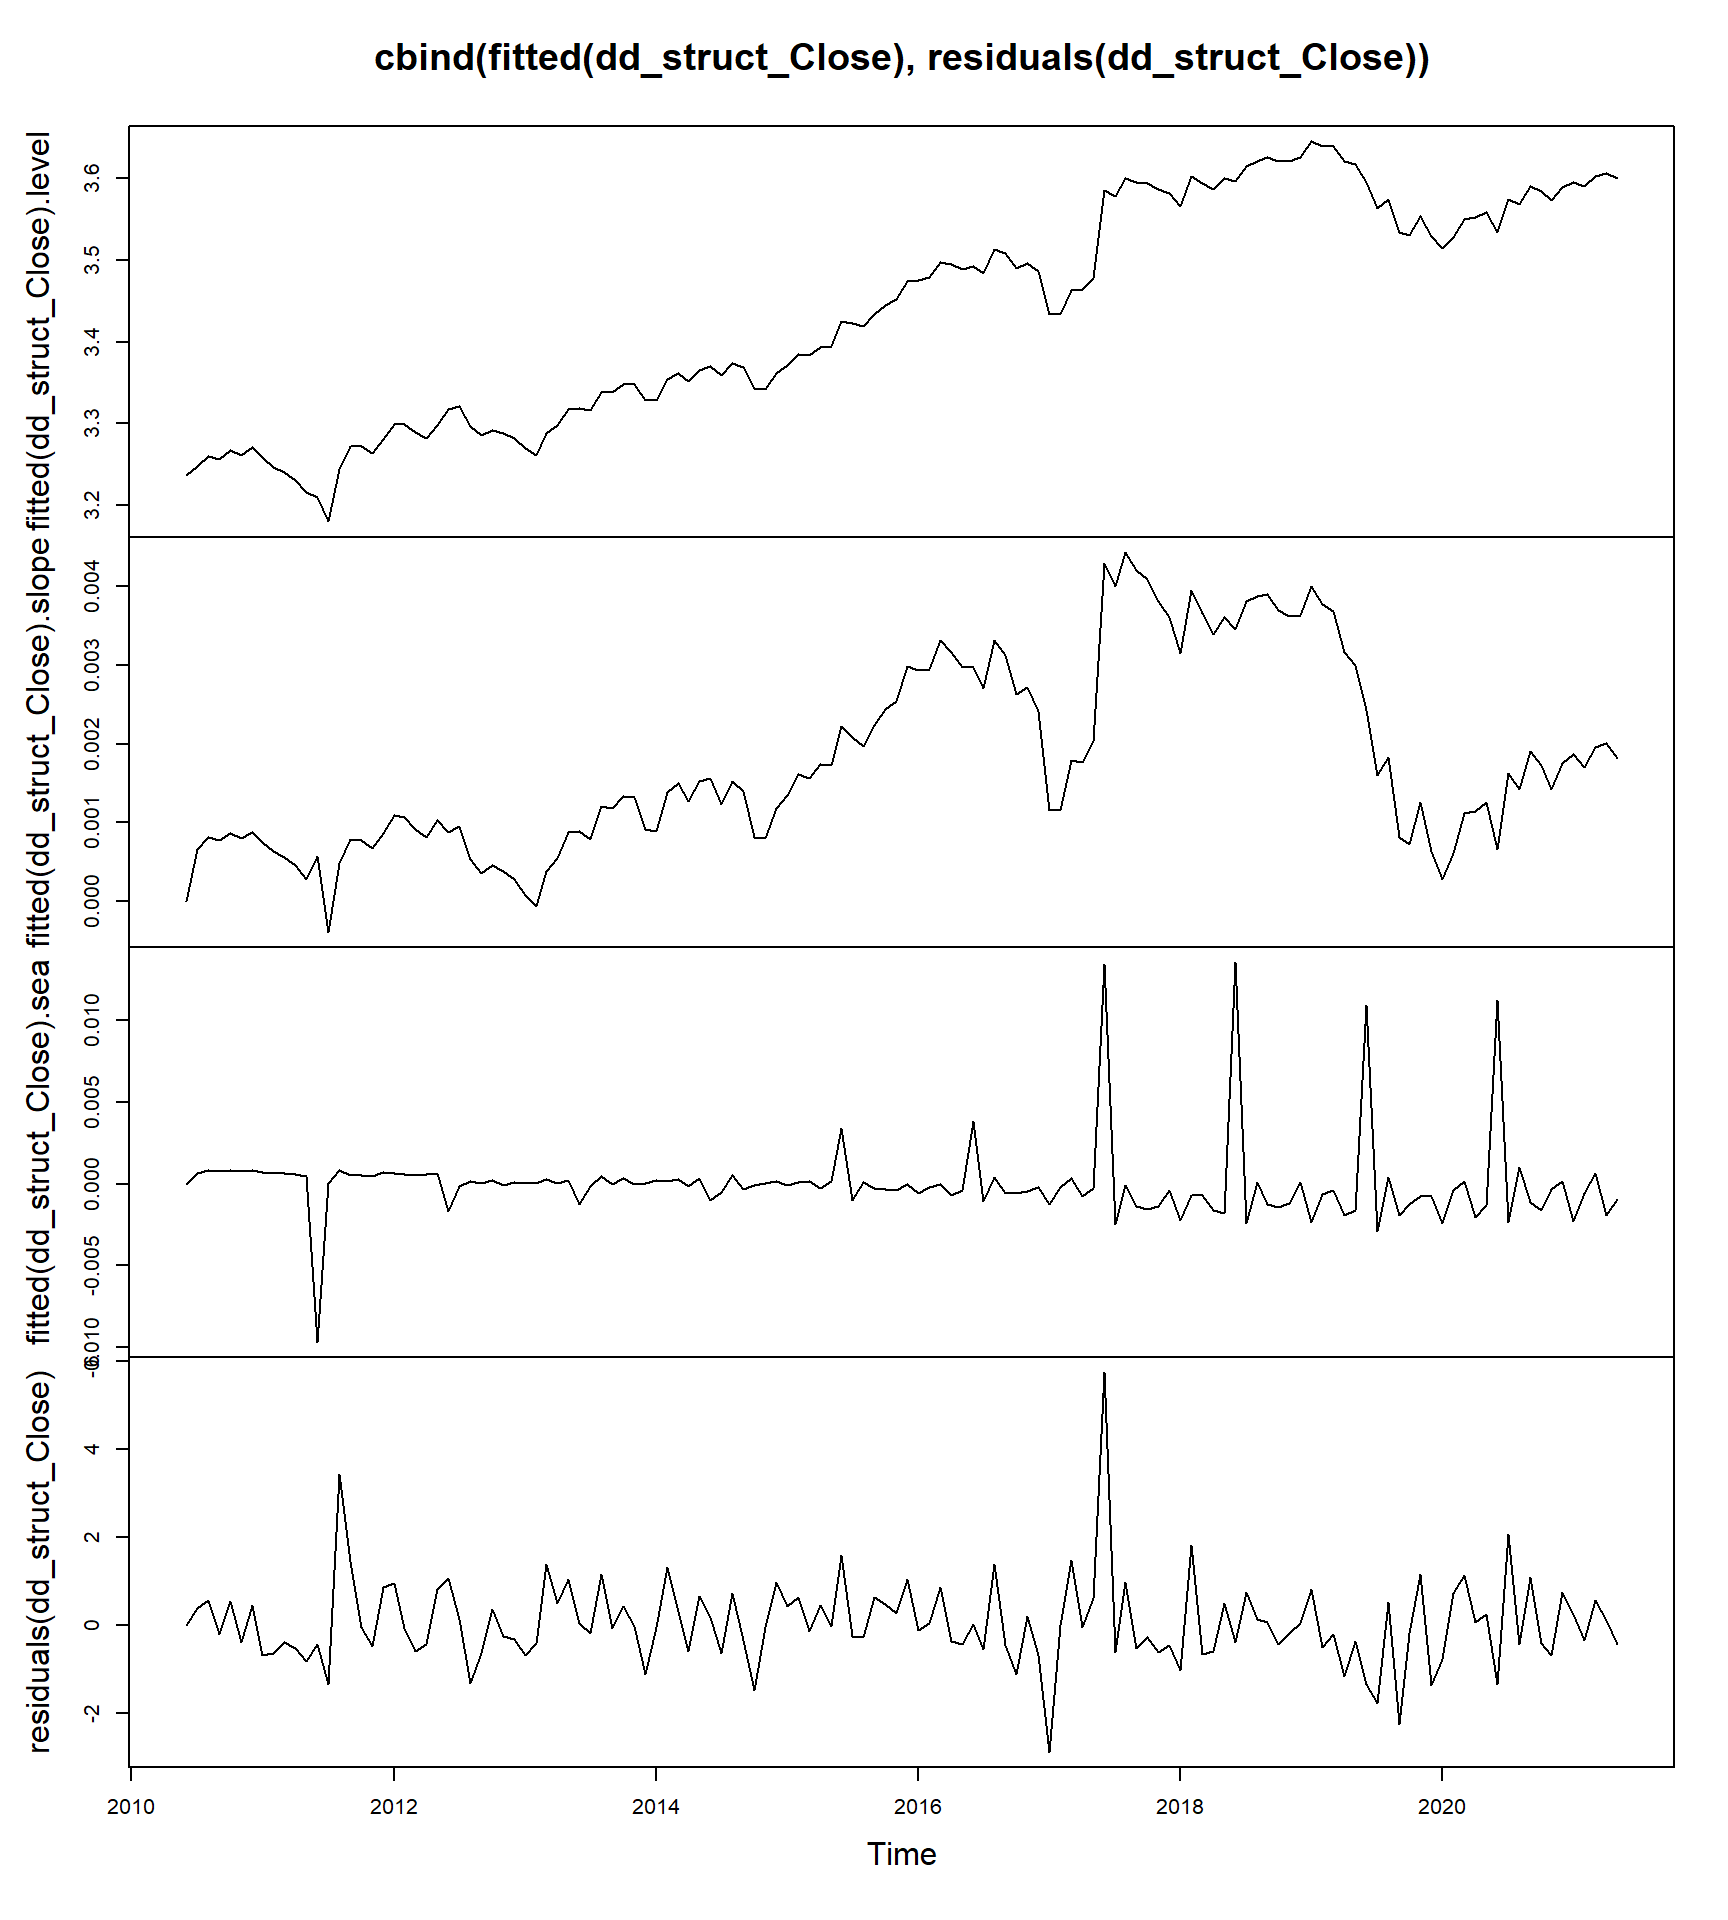
dd_struct_Vol <- StructTS(log(CORN[,"CORN.Volume"]))

plot(cbind(fitted(dd_struct_Vol), residuals(dd_struct_Vol)))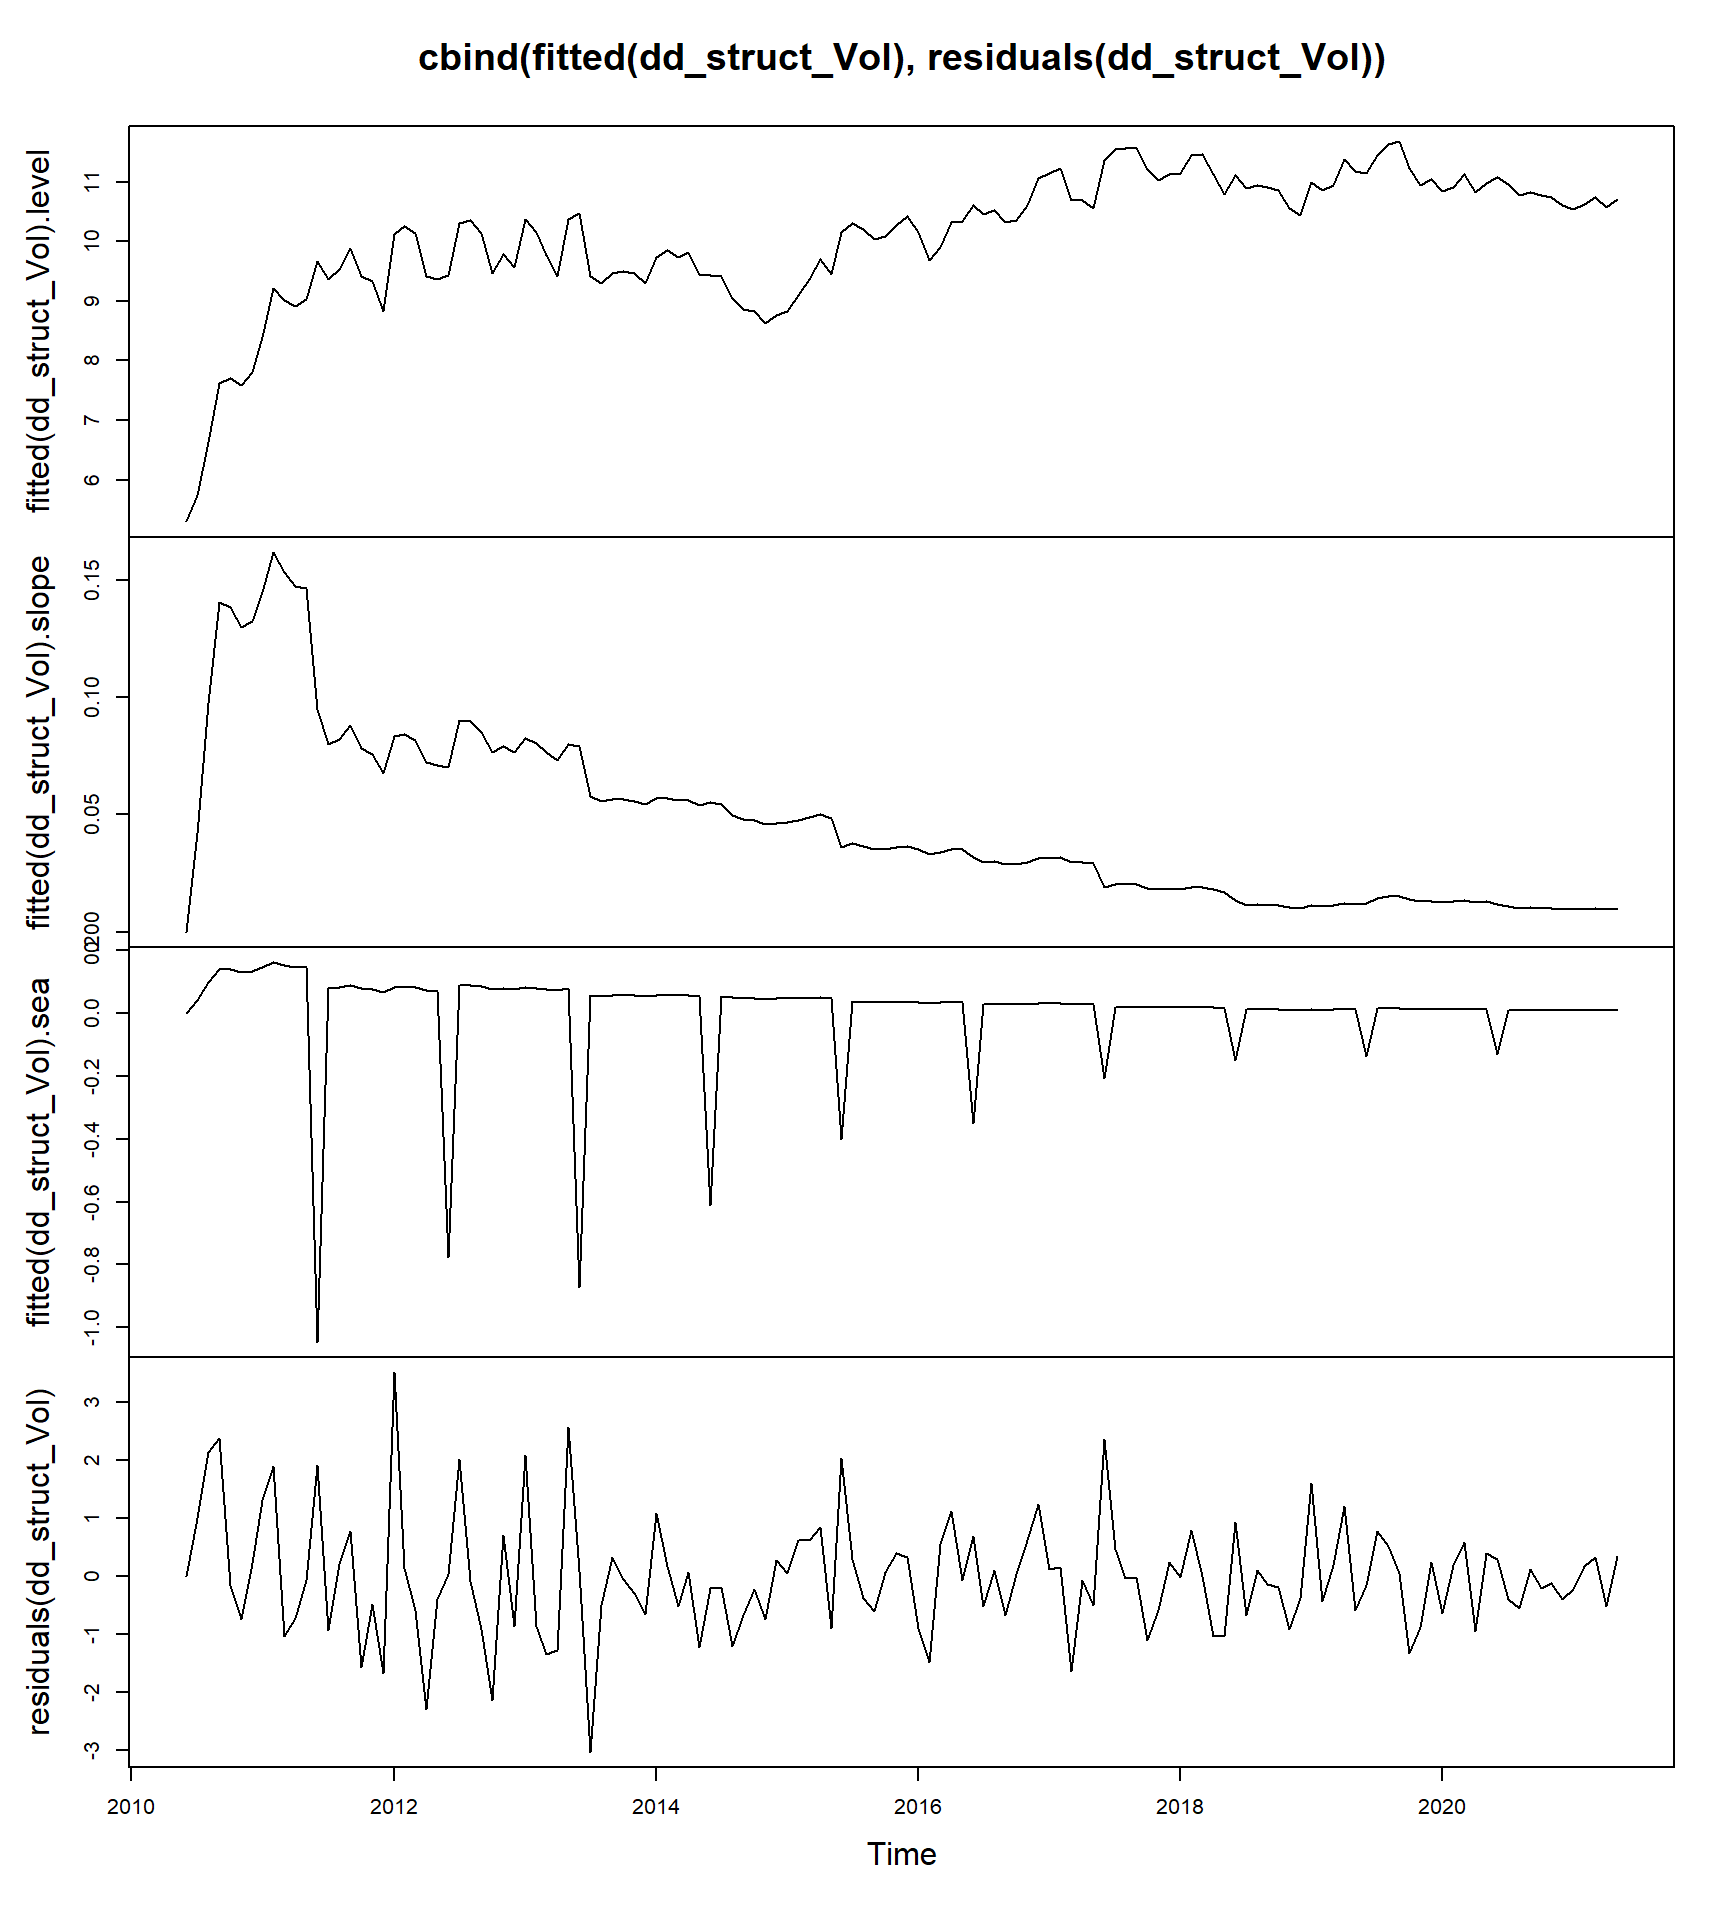
Testagem de Modelos de Previsão
treino <- window(log(CORN[,c("CORN.Close","CORN.Volume")]), start = c(2007,1), end = c(2019,4)) # Pego o período onde o gráfico aponta inversão de trajetoria ate os ultimos 24 meses anteriores ao final da serie

teste <- window(log(CORN[,c("CORN.Close","CORN.Volume")]), start = c(2019,5)) # Conjunto de teste contempla aprox os ultimos 24 meses em diante

glimpse(treino)
Time-Series [1:107, 1:2] from 2010 to 2019: 3.24 3.25 3.26 3.26 3.27 ...
- attr(*, "dimnames")=List of 2
..$ : NULL
..$ : chr [1:2] "CORN.Close" "CORN.Volume"Construo os modelos para avaliação de performance preditiva:
tail(treino) CORN.Close CORN.Volume
Nov 2018 3.618993 10.13062
Dec 2018 3.625407 10.26813
Jan 2019 3.644144 11.78295
Feb 2019 3.636533 10.67821
Mar 2019 3.637323 11.04612
Apr 2019 3.614695 11.96845horizonte <- 24 # Horizonte de projeção para os proximos 24 mesesSNAIVE
De acordo com Hyndman & Anastopoulous (p. 57, 2018):
For naïve forecasts, we simply set all forecasts to be the value of the last observation. That is,
\[ \widehat{y}_{T+h|T}=y_{T} \]
This method works remarkably well for many economic and financial time series. Because a naïve forecast is optimal when data follow a random walk, these are also called random walk forecasts. A similar method is useful for highly seasonal data. In this case, we set each forecast to be equal to the last observed value from the same season of the year (e.g., the same month of the previous year). Formally, the forecast for time T+h is written as
\[ \widehat{y}_{T+h|T}=y_{T+h-m(k+1)}, \]
where \(m=\) the seasonal period, and \(k\) is the integer part of \((h-1)/m\) (i.e., the number of complete years in the forecast period prior to time \(T+h\)). This looks more complicated than it really is. For example, with monthly data, the forecast for all future February values is equal to the last observed February value. With quarterly data, the forecast of all future Q2 values is equal to the last observed Q2 value (where Q2 means the second quarter). Similar rules apply for other months and quarters, and for other seasonal periods.
SNAIVE <- snaive(diff(CORN[,"CORN.Close"]), h = horizonte)
#summary(SNAIVE)
autoplot(SNAIVE)+autolayer(fitted(SNAIVE))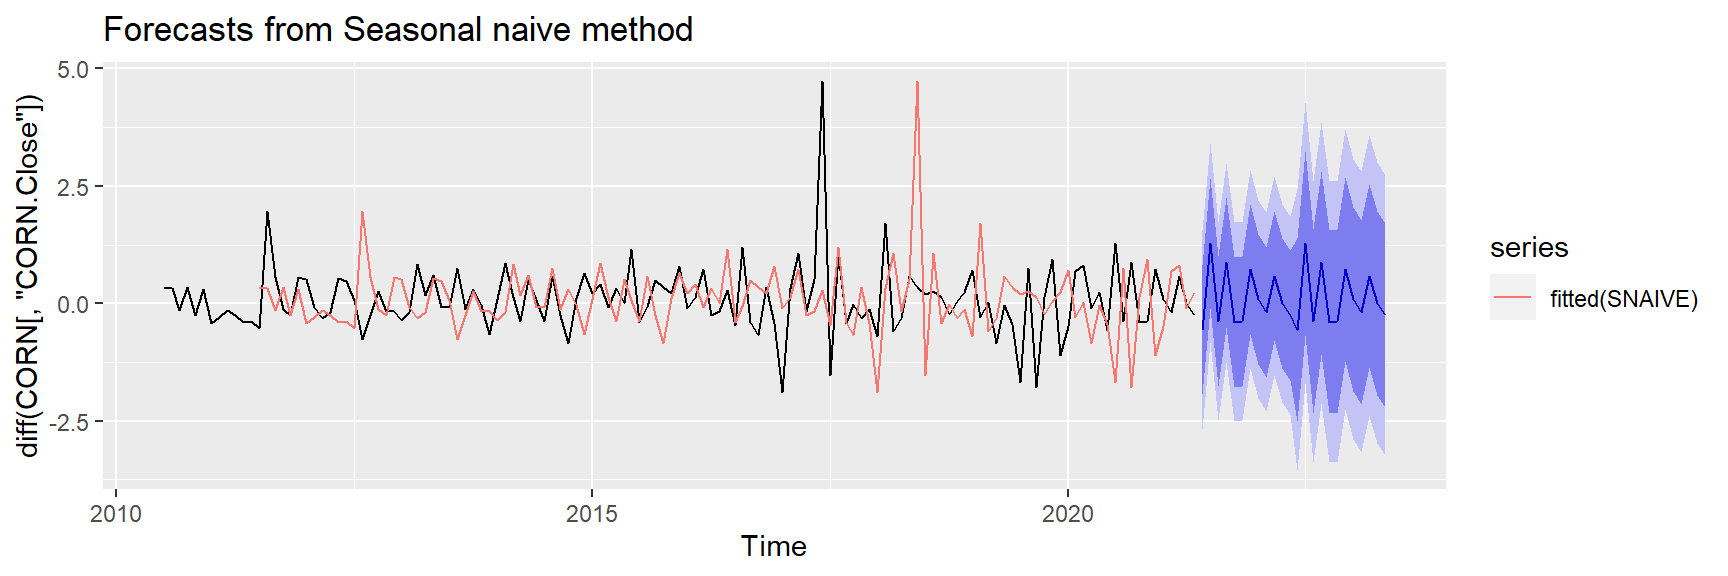
checkresiduals(SNAIVE)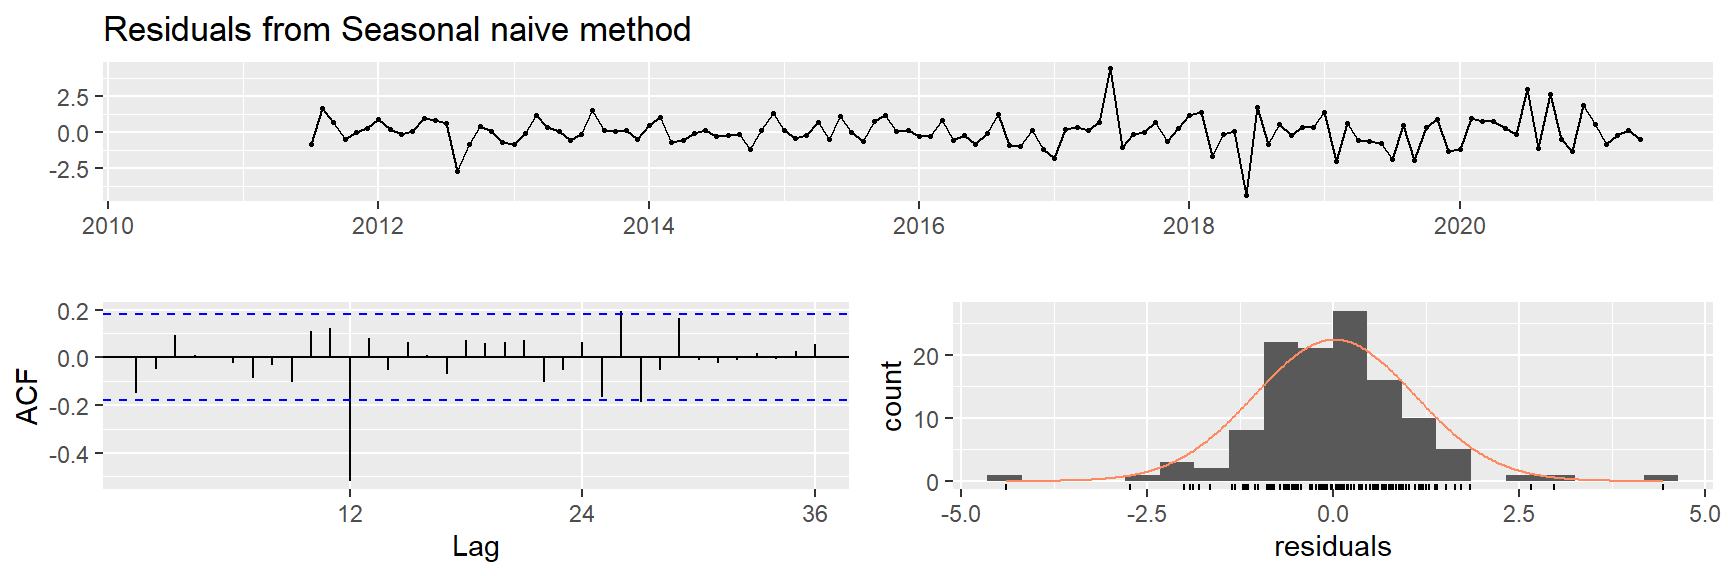
    Ljung-Box test

data:  Residuals from Seasonal naive method
Q* = 54.371, df = 24, p-value = 0.0003803

Model df: 0.   Total lags used: 24
Random Walk com drift
Quando se assume que o comportamento dos preços de um ativo segue a hipótese de Random Walk, diz-se que ele obedece ao Processo de Markov, um processo estocástico em que o comportamento de uma variável durante um período curto de tempo depende somente do valor da variável no início do período, e não de seu histórico. O preço dos títulos, principalmente das ações, é tido como um processo de Markov. Se isso for verdadeiro, como salienta Hull, nossas previsões sobre o futuro dos títulos não devem ser afetadas pelos preços dos mesmos há uma semana, um mês ou mesmo um ano atrás. Previsões para o futuro são incertas e devem ser expressas em termos de distribuições probabilísticas.
A estimação deste modelo é definida por Hyndman & Anastopoulous (p. 57, 2018):
A variation on the naïve method is to allow the forecasts to increase or decrease over time, where the amount of change over time (called the drift) is set to be the average change seen in the historical data. Thus the forecast for time is given by
\[ \widehat{y}_{T+h|T}=y_{T}+ \frac{h}{T-1}\displaystyle\sum^{T}_{t=2}(y_{t}-y_{t-1})= y_{T}+h (\frac{y_{T}-y_{1}}{T-1}) \] This is equivalent to drawing a line between the first and last observations, and extrapolating it into the future.
RW_drift <- rwf(diff(CORN[,"CORN.Close"]), h = horizonte, drift=TRUE)

autoplot(RW_drift)+autolayer(fitted(RW_drift))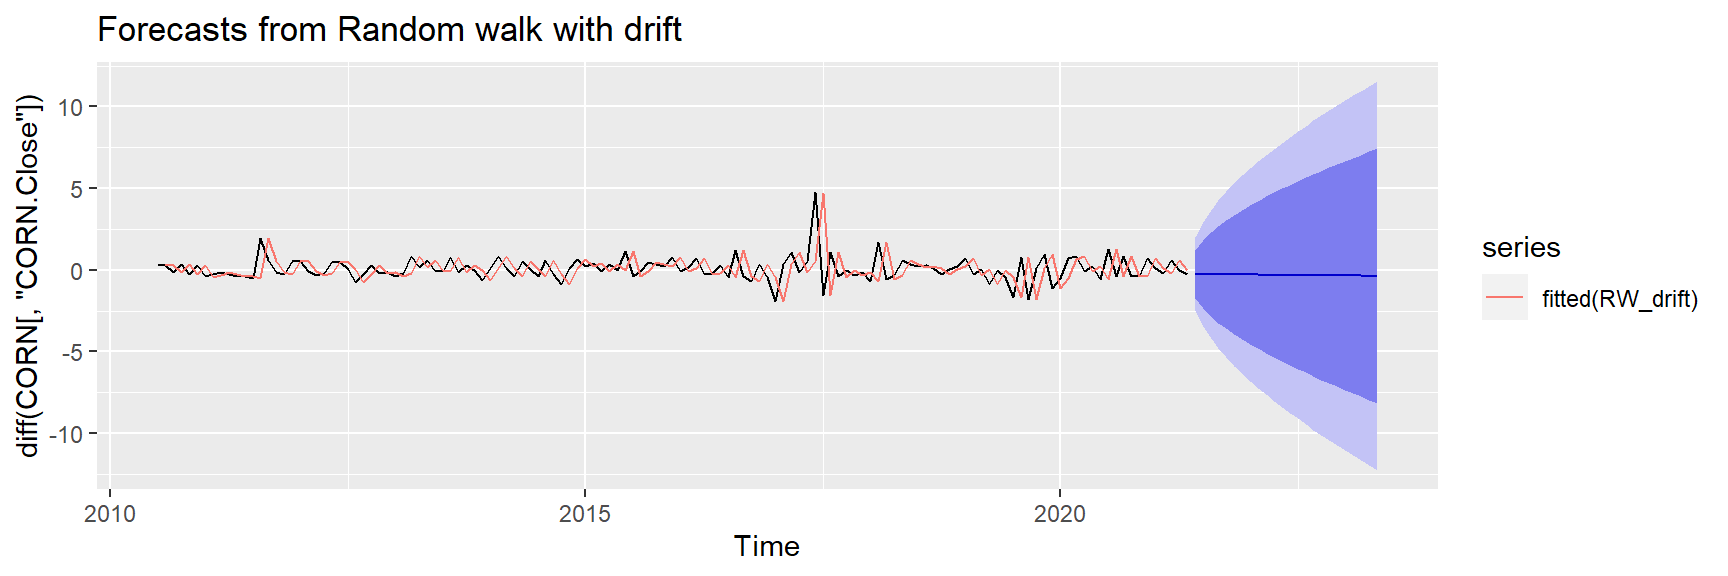
checkresiduals(RW_drift)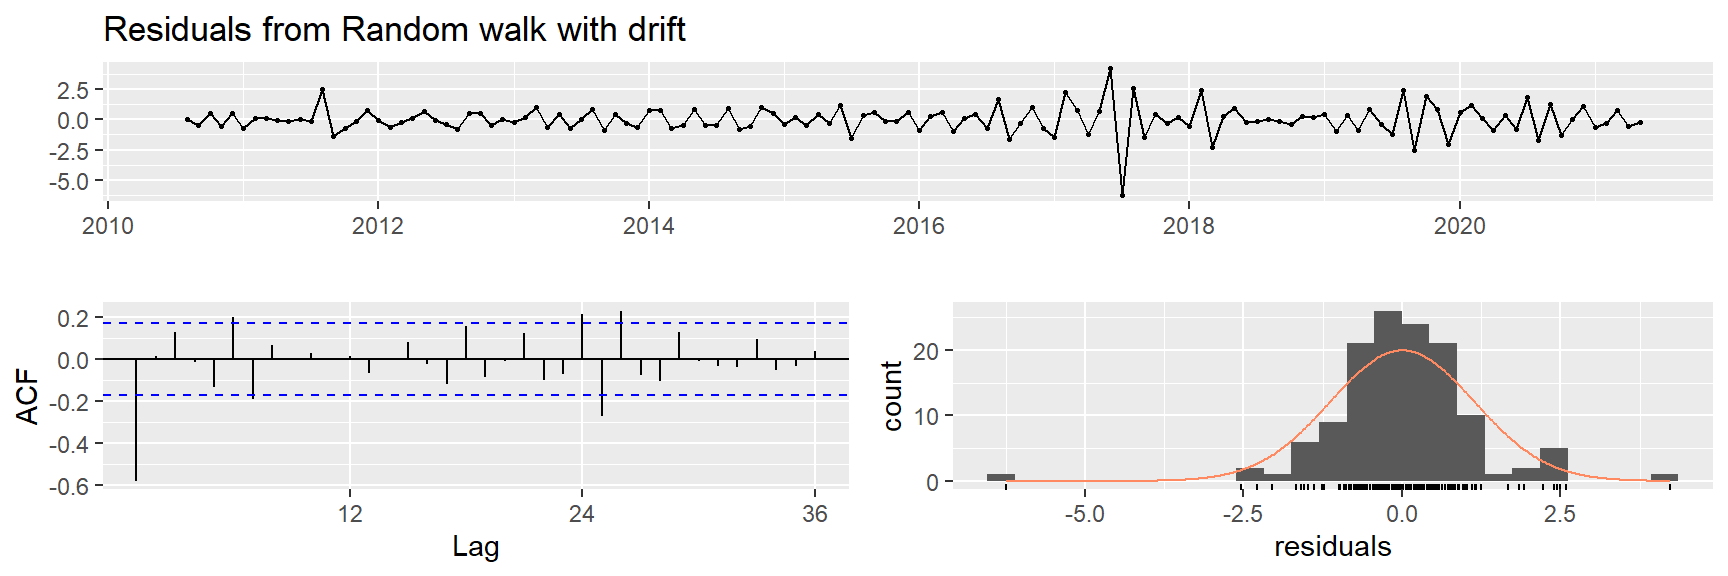
    Ljung-Box test

data:  Residuals from Random walk with drift
Q* = 81.247, df = 23, p-value = 1.992e-08

Model df: 1.   Total lags used: 24
Gujarati e Porter (p. 731, 2011) define o fenômeno como:
"(...) algumas séries temporais financeiras, como os preços das ações, exibem o que é conhecido como fenômeno do passeio aleatório. Isso significa que a melhor previsão do preço de uma ação, por exemplo, da IBM, amanhã seja igual ao preço de hoje mais um choque puramente aleatório (ou termo de erro). Se esse for realmente o caso, prognosticar os preços dos ativos seria um exercício inútil."
SES
SES <- ses(diff(CORN[,"CORN.Close"]), h = horizonte) # Simple Exponential Smoothing

autoplot(SES)+autolayer(fitted(SES))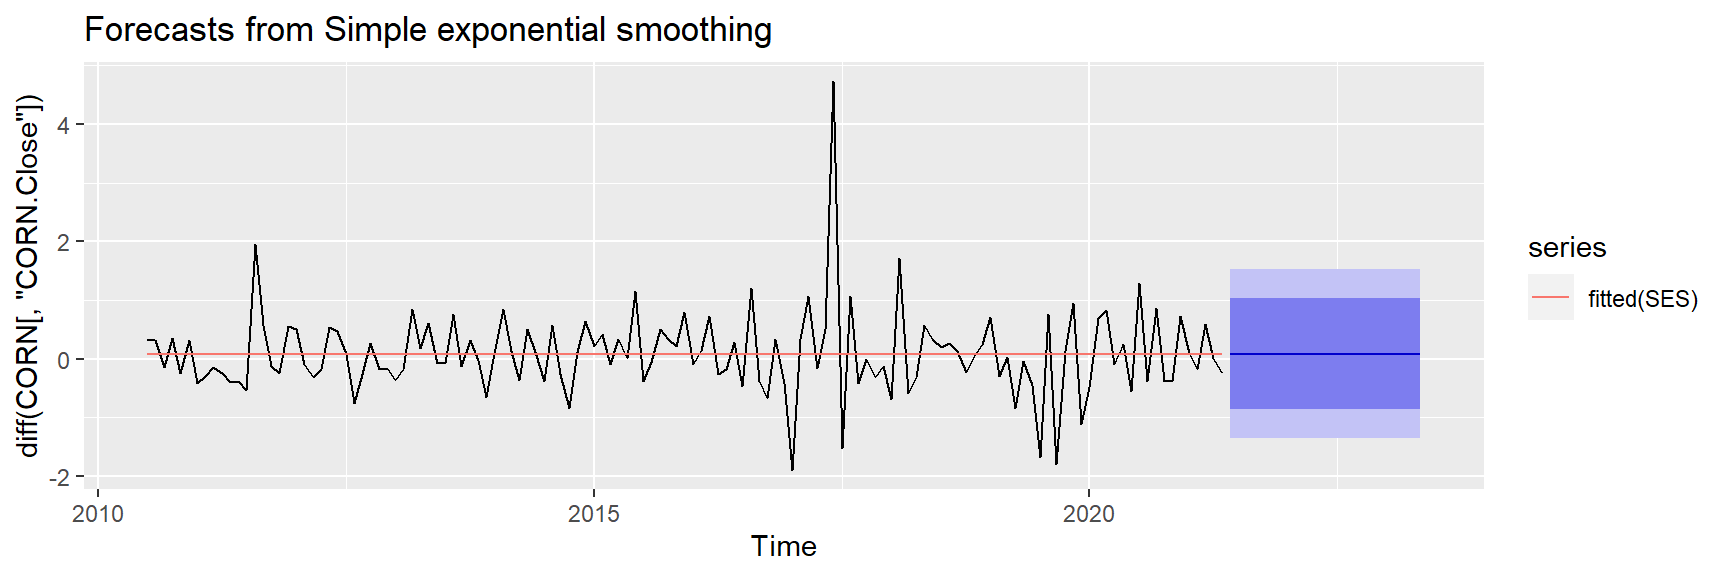
checkresiduals(SES)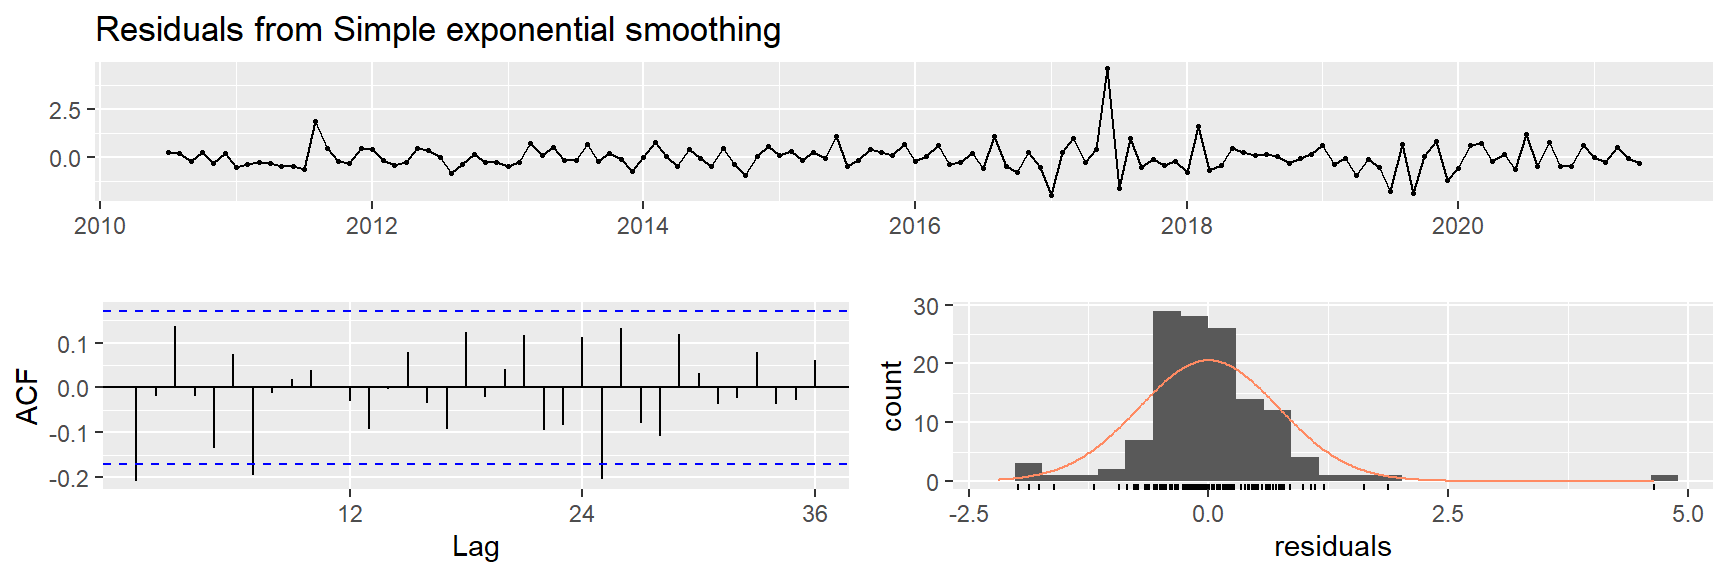
    Ljung-Box test

data:  Residuals from Simple exponential smoothing
Q* = 30.861, df = 22, p-value = 0.09899

Model df: 2.   Total lags used: 24
Holt
HOLT <- holt(diff(CORN[,"CORN.Close"]), h = horizonte)

autoplot(HOLT)+autolayer(fitted(HOLT))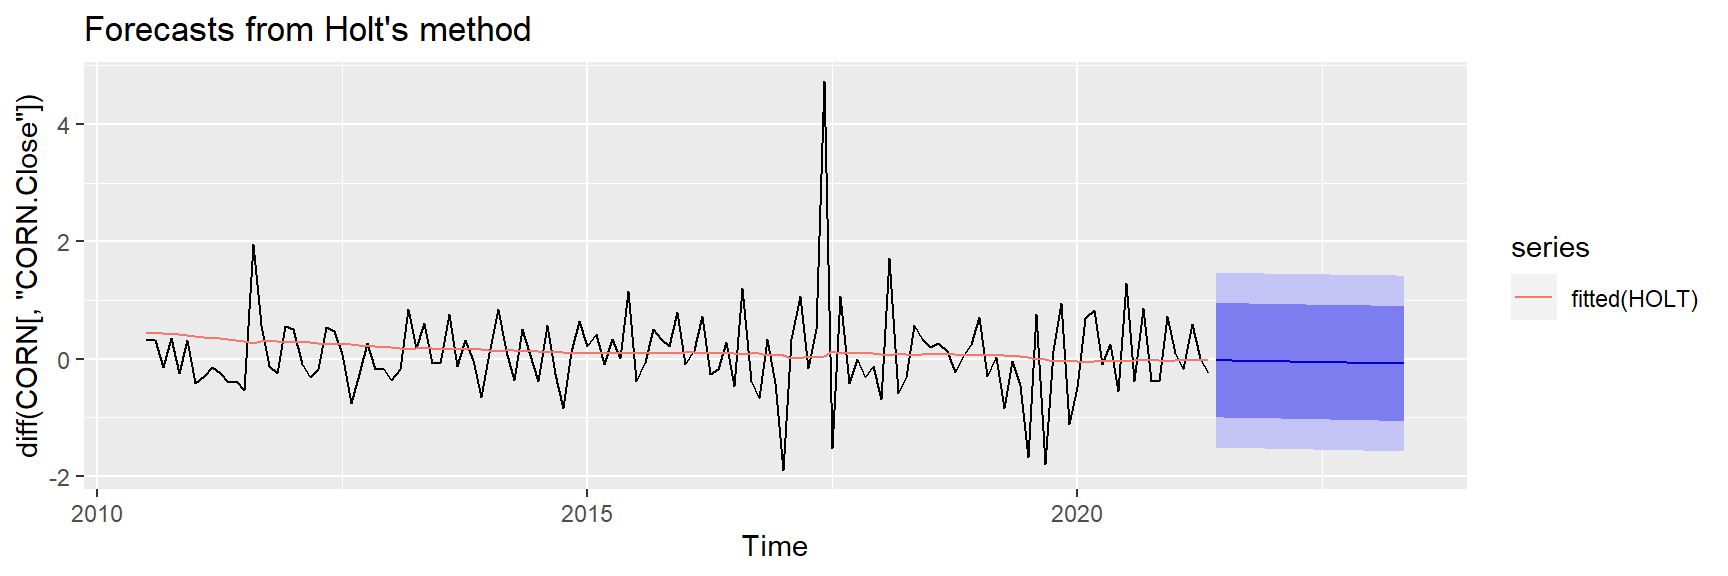
checkresiduals(HOLT)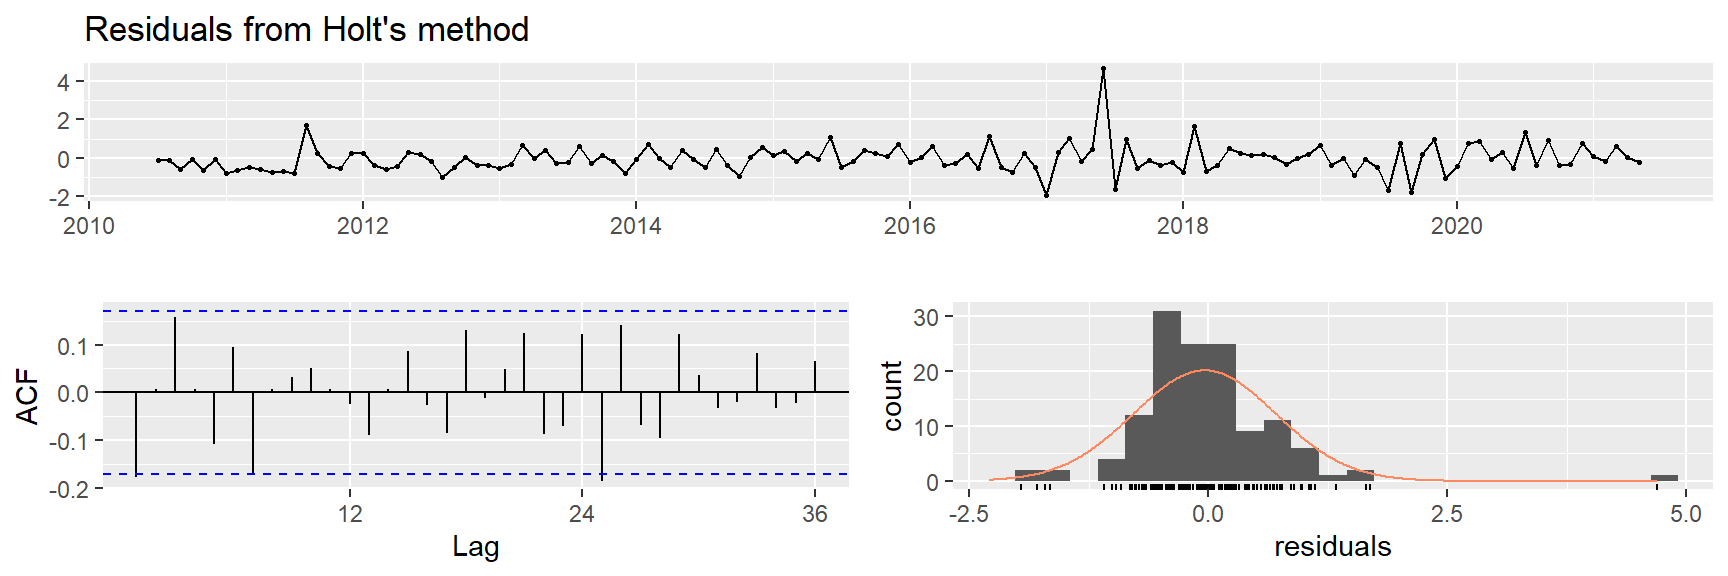
    Ljung-Box test

data:  Residuals from Holt's method
Q* = 28.682, df = 20, p-value = 0.09421

Model df: 4.   Total lags used: 24
HOLT_aditivo <- hw(diff(CORN[,"CORN.Close"]), seasonal = "additive", h = horizonte)
autoplot(HOLT_aditivo)+autolayer(fitted(HOLT_aditivo))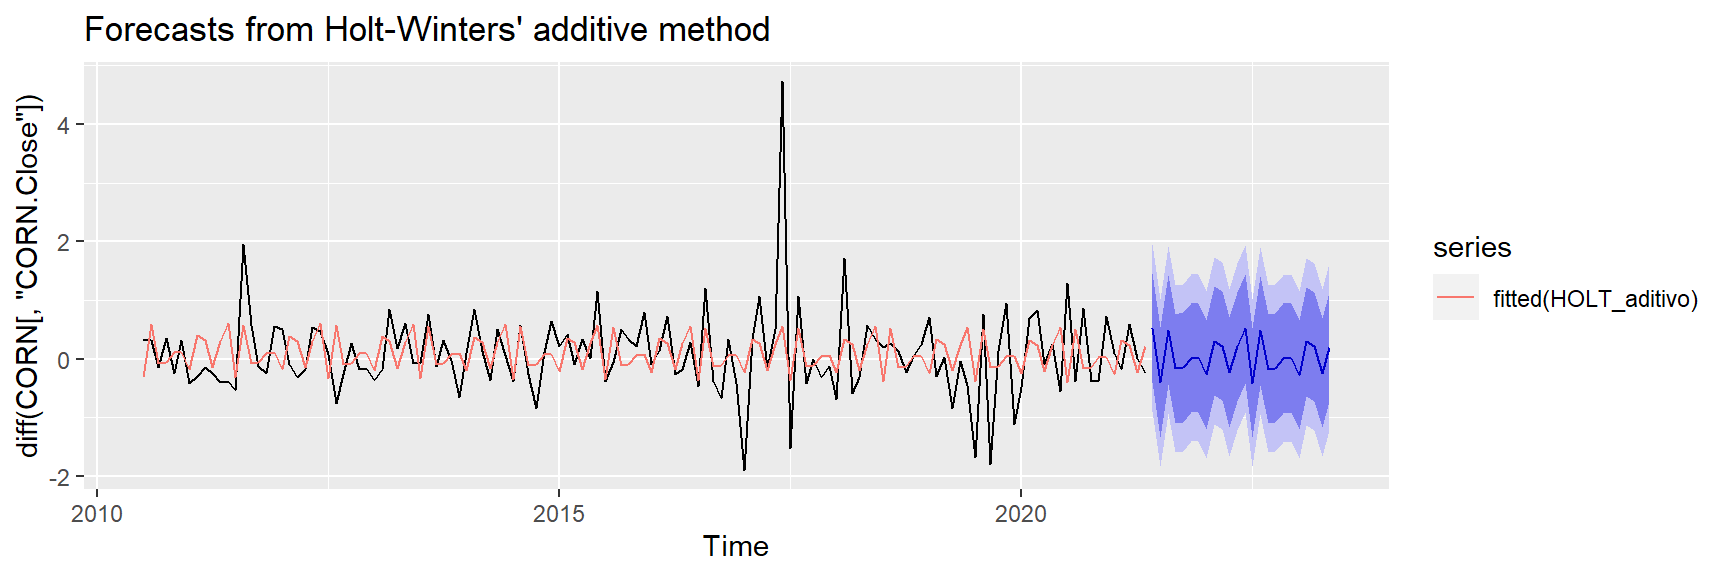
checkresiduals(HOLT_aditivo)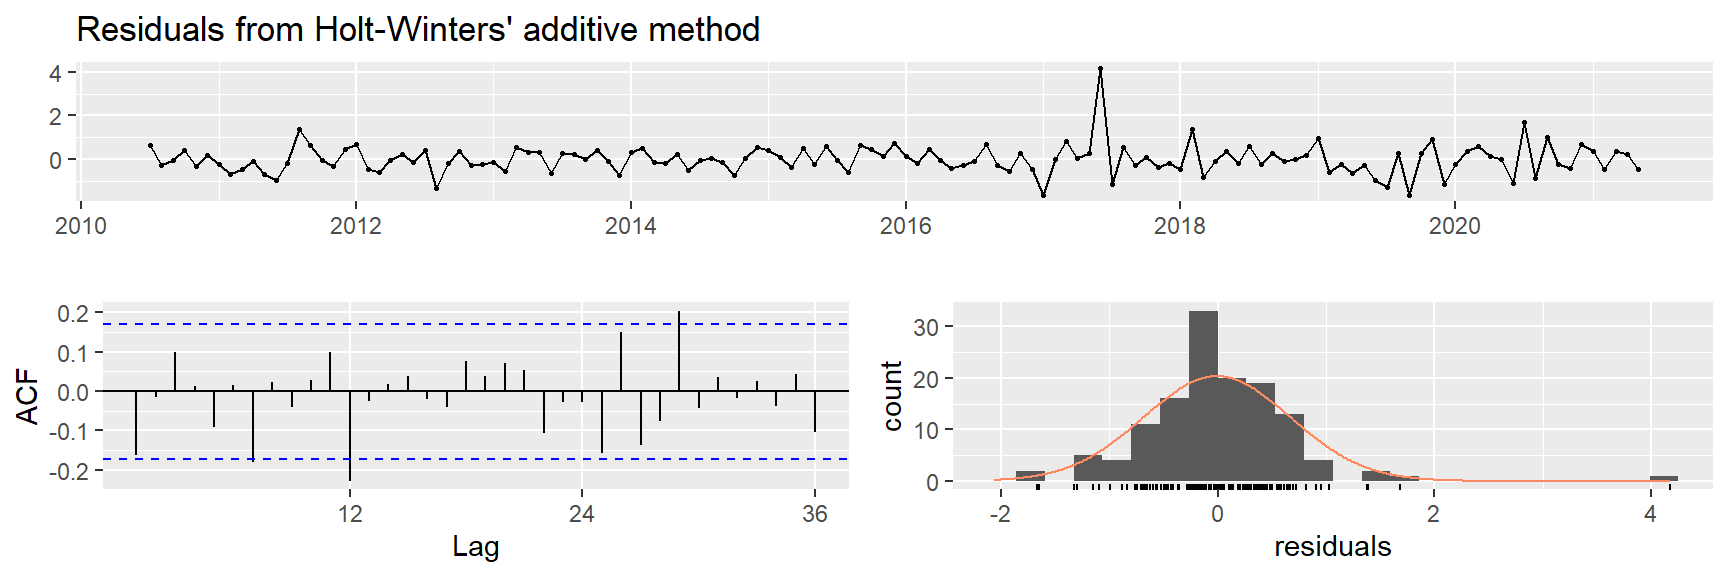
    Ljung-Box test

data:  Residuals from Holt-Winters' additive method
Q* = 25.181, df = 8, p-value = 0.001448

Model df: 16.   Total lags used: 24
ARIMA
ARIMA <- auto.arima(diff(CORN[,"CORN.Close"]), stepwise = TRUE, seasonal = TRUE)

ARIMA %>% forecast() %>% autoplot()+autolayer(fitted(ARIMA))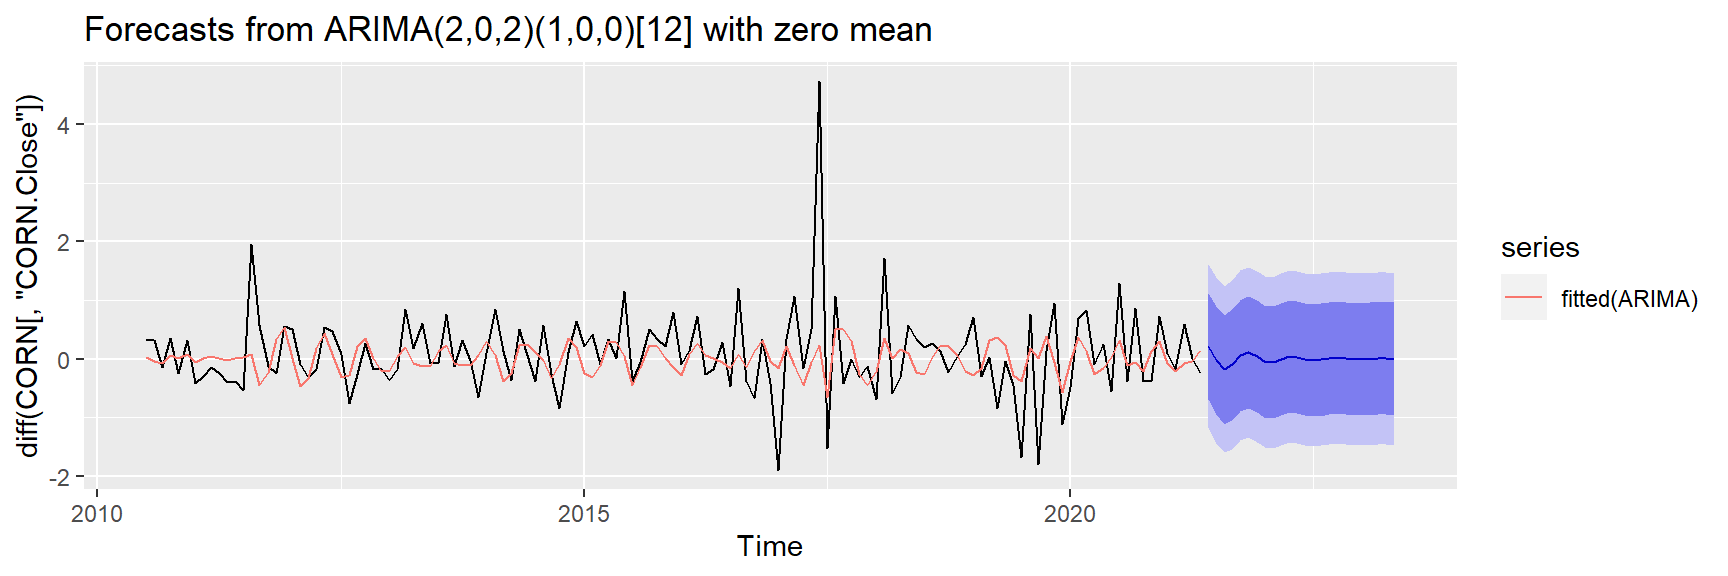
checkresiduals(ARIMA)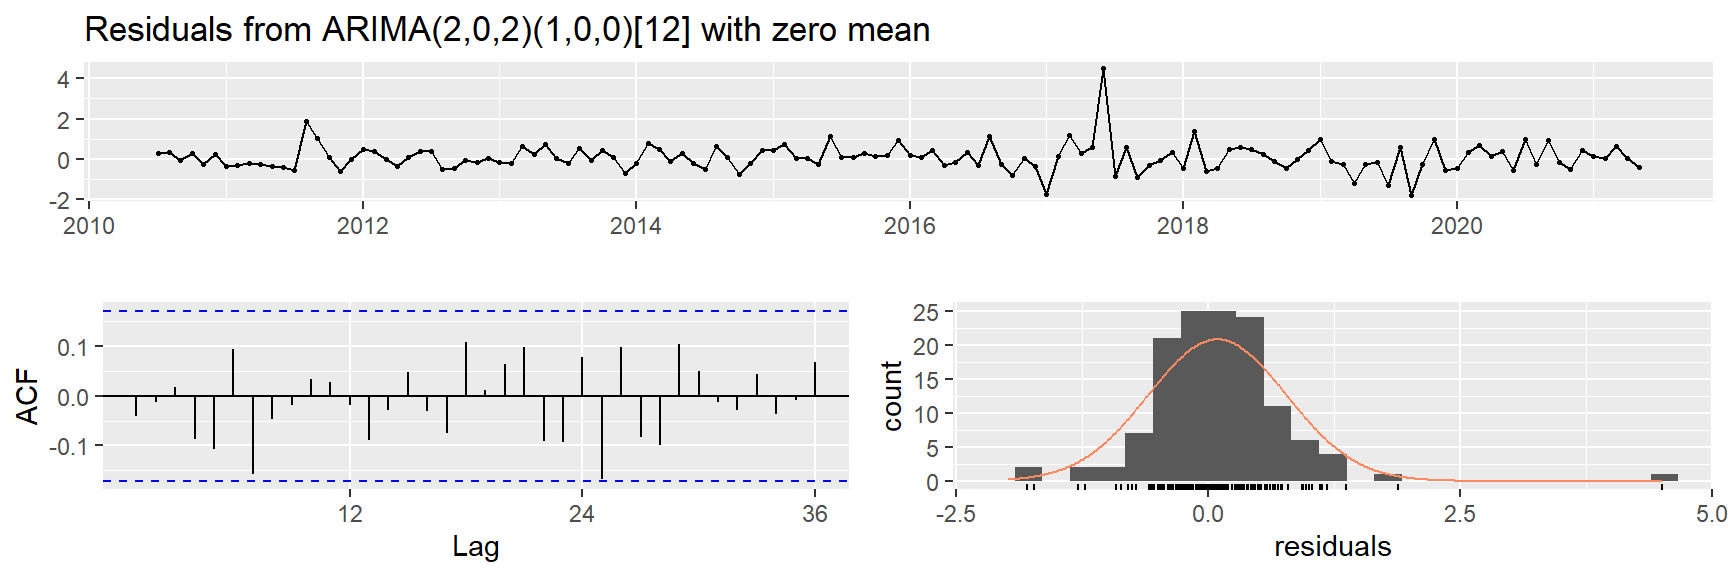
    Ljung-Box test

data:  Residuals from ARIMA(2,0,2)(1,0,0)[12] with zero mean
Q* = 18.652, df = 19, p-value = 0.4793

Model df: 5.   Total lags used: 24
SARIMA <- sarima.for(diff(CORN[,"CORN.Close"]), p = 2, d = 1, q = 1, P = 2, D = 1, Q = 1, S = 12, n.ahead = horizonte)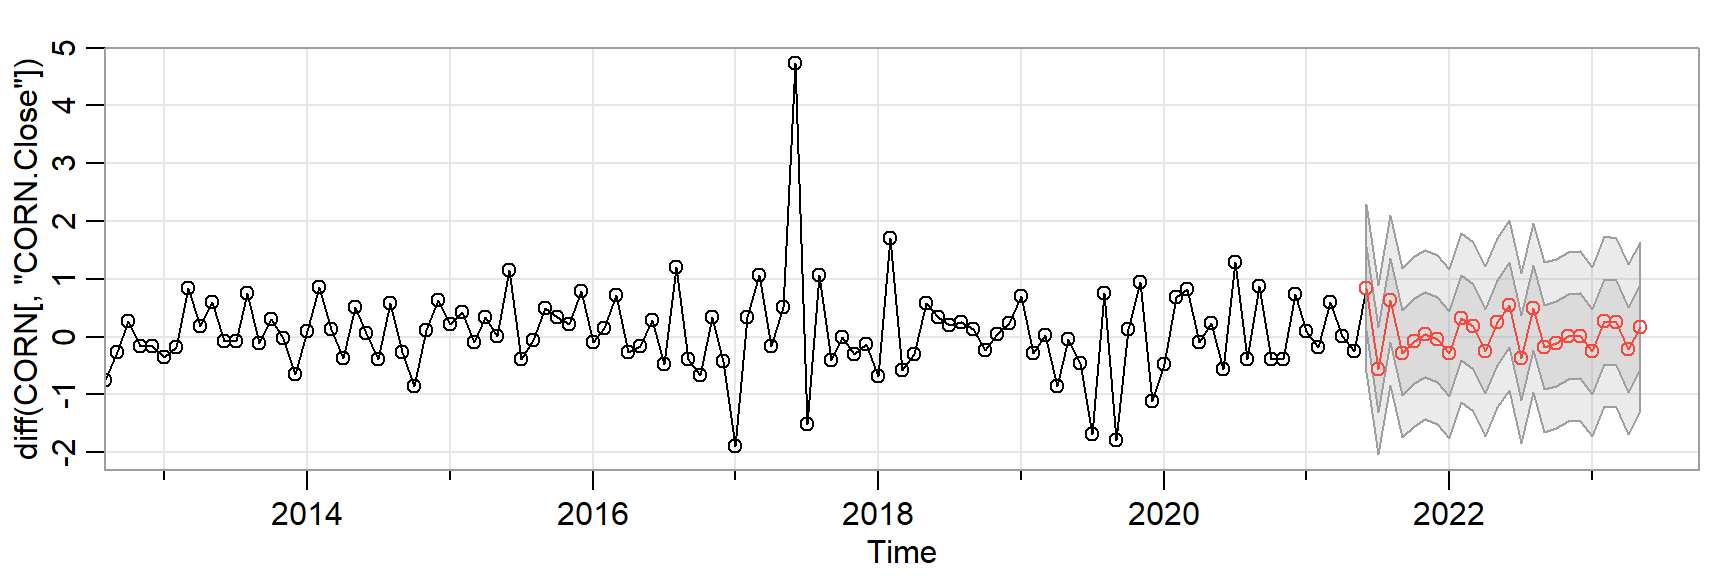
summary(SARIMA) Length Class Mode
pred 24 ts numeric
se 24 ts numeric#checkresiduals(SARIMA)Mais importante, nas séries temporais econômicas, os valores sucessivos (defasagens) tendem a estar altamente correlacionados, com o que o fantasma da multicolinearidade faz sua aparição. A multicolinearidade conduz a estimativas pouco precisas, isto é, os erros-padrão tendem a ser grandes em relação aos coeficientes estimados. Em consequência, com base nas razões \(t\) estimadas, podem indicar (equivocadamente) que um coeficiente defasado é estatisticamente insignificante.
TBATS
TBATS <- tbats(diff(CORN[,"CORN.Close"]))

TBATS %>% forecast() %>% autoplot()+autolayer(fitted(TBATS))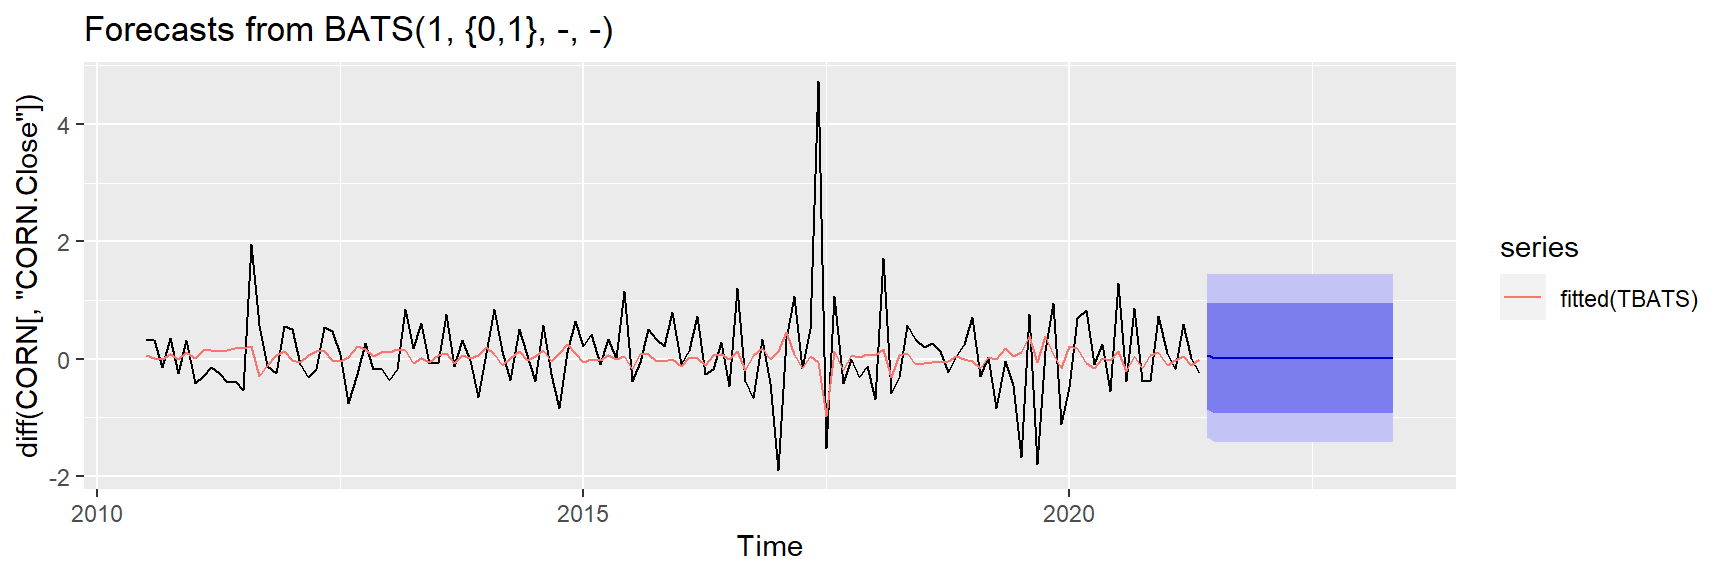
checkresiduals(TBATS)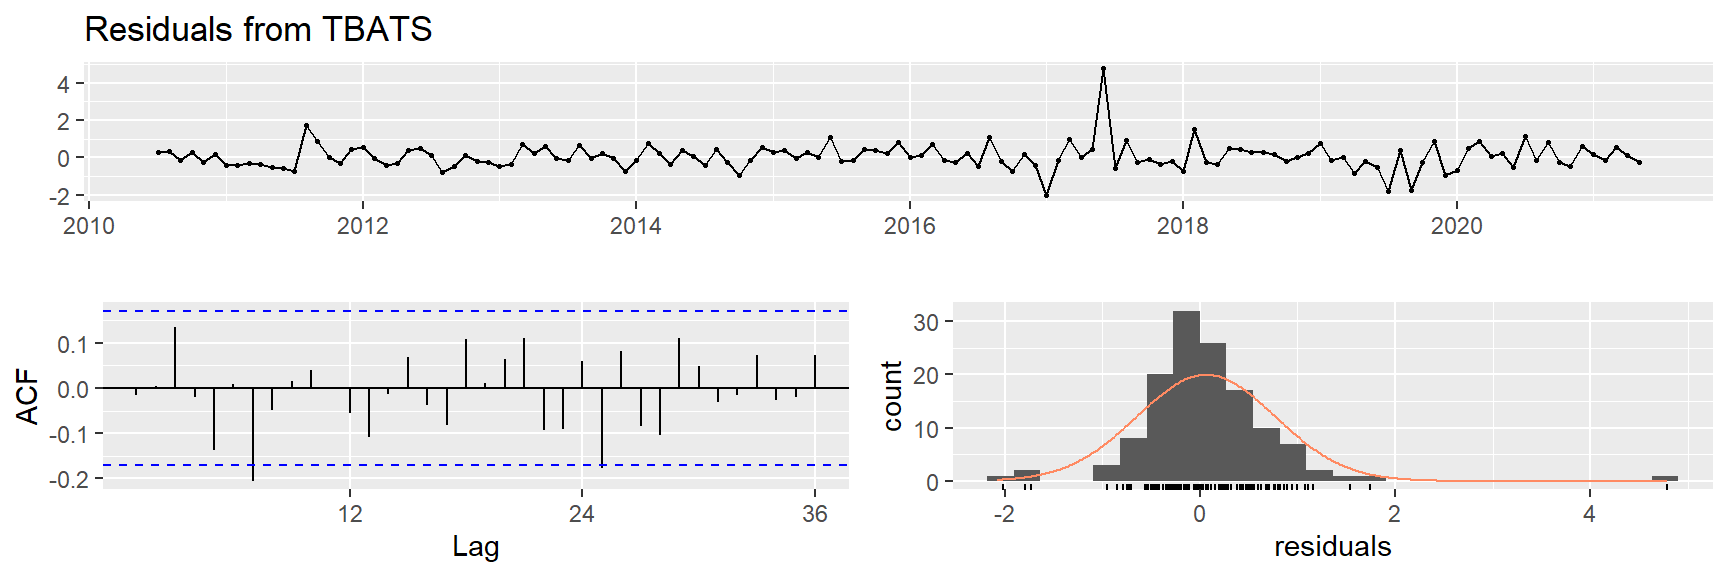
    Ljung-Box test

data:  Residuals from TBATS
Q* = 23.738, df = 20, p-value = 0.254

Model df: 4.   Total lags used: 24
NNETAR
NNETAR <- nnetar(log(CORN[,"CORN.Close"]), lambda=0)

autoplot(forecast(NNETAR,h=horizonte))+autolayer(fitted(NNETAR))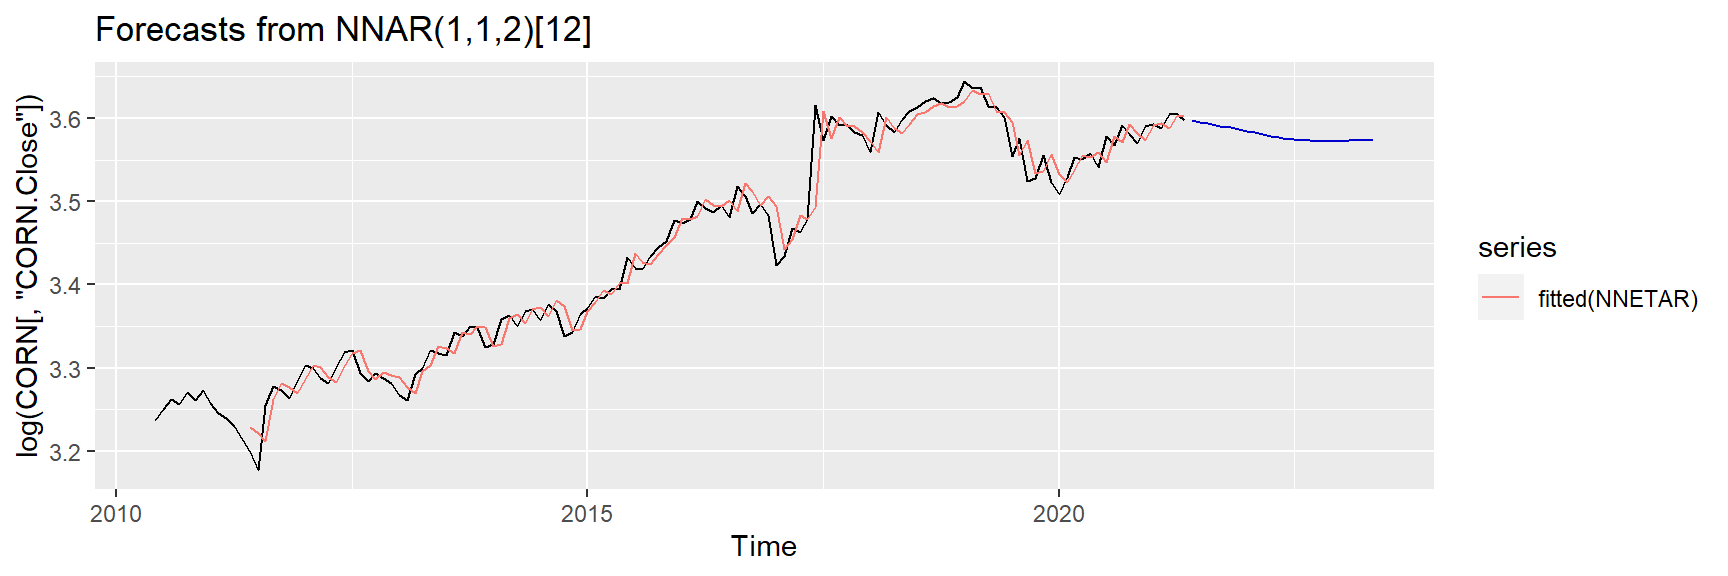
#checkresiduals(NNETAR)Comparativo
accuracy(SNAIVE) ME RMSE MAE MPE MAPE MASE ACF1
Training set 0.02008401 1.078867 0.7614289 64.43723 342.6246 1 -0.1505039accuracy(SES) ME RMSE MAE MPE MAPE MASE
Training set -0.0001321297 0.7297602 0.494837 97.84919 125.3685 0.6498795
ACF1
Training set -0.2087569accuracy(HOLT) ME RMSE MAE MPE MAPE MASE
Training set -0.04282088 0.7482362 0.5181964 117.4604 141.5968 0.6805579
ACF1
Training set -0.1777675accuracy(HOLT_aditivo) ME RMSE MAE MPE MAPE MASE
Training set -0.009811824 0.6806759 0.4767178 90.57539 189.4386 0.6260832
ACF1
Training set -0.1626575accuracy(ARIMA) ME RMSE MAE MPE MAPE MASE
Training set 0.08514266 0.6918357 0.4675432 68.51801 169.1002 0.6140339
ACF1
Training set -0.04065358accuracy(TBATS) ME RMSE MAE MPE MAPE MASE
Training set 0.05933488 0.7126063 0.4718614 107.2725 115.8288 0.6017458
ACF1
Training set -0.01469587accuracy(NNETAR) ME RMSE MAE MPE MAPE
Training set 6.922822e-05 0.02172907 0.01537886 -0.002010851 0.4456349
MASE ACF1
Training set 0.2736522 -0.1374199Modelos de Heterocedasticidade Condicial
Assim como o termo de erro \(u\) no tempo \(t\) pode estar correlacionado com o termo de erro no tempo (\(t – 1\)) em um processo AR(1) ou com os vários termos de erro defasados em um processo geral AR(\(p\)), pode haver autocorrelação na variância \(\sigma^2\) no tempo \(t\) com seus valores defasados em um ou mais períodos?
Tal autocorrelação foi observada pelos pesquisadores na previsão de séries temporais, como preços de ações, taxas de inflação e taxas de câmbio. Essa autocorrelação recebe nomes como heterocedasticidade condicional autorregressiva (ARCH, do inglês autoregressive conditional heteroscedasticity), se a variância do erro estiver relacionada com o termo de erro elevado ao quadrado no período anterior, e heterocedasticidade condicional autorregressiva generalizada (GARCH, do inglês generalized autoregressive conditional heteroscedasticity), se a variância do erro estiver relacionada com os termos de erro elevados ao quadrado em vários períodos anteriores.
\[\\[1in]\]
\[\\[1in]\]
Referências
Diebold, Francis X. Elements of forecasting. 2. ed. South Western Publishing, 2001. p. 254.
Franses, P.H. Time Series Models for Business and Economic Forecasting. Cambridge: Cambridge University Press, 1998.
R Core Team (2020). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. URL https://www.R-project.org/.
Granger, C. W. J. Investigating causal relations by econometric models and cross-spectral methods. In Econometrica, p. 424-438, jul. 1969.
Gujarati, D. N., Porter, D. Econometria Básica, quinta ed. São Paulo, 2011.
Hyndman, R., J., Athanasopoulos, G. Forecasting:Principles and Practice, Monash University, Australia, 2018.
Hull, J.C. Options, Futures & Other Derivatives, 5Th ed, 2002, Prentice Hall
Koop, G. Analysis of economic data. Nova York: John Wiley & Sons, 2000.
Morettin, P. Econometria Financeira: Um curso de séries temporais financeiras, 2a. ed. revista e ampliada, São Paulo, 2006.
Shleifer, A. Inefficient Markets: an introduction to Behavioral Finance. Oxford University Press, 2000.
Thurman W.N. & Fisher M.E, Chickens, Eggs, and Causality, or Which Came First?, American Journal of Agricultural Economics, 1988, 237-238.