Disciplina Algoritmos para Ciência de Dados com Weka + R
Rodrigo Hermont Ozon
Last Update: maio 30, 2023
start_time <- Sys.time()
#start_time
Resolução da atividade da disciplina Algoritmos para Ciência de Dados
Solução da AAS conforme print a seguir

Reprodução da vídeoaula com o dataset A4
O preview do primeiro dataset pode ser visto conforme segue:
Rows: 4,773
Columns: 6
$ Idade   <int> 4, 1, 0, 4, 2, 2, 4, 1, 2, 4, 1, 1, 1, 2, 1, 1, 2, 2, 1, 4, 1, 1, 0, 1, 4, 4, 0, 1, 4, 4, 1, 0, 2, 2, 2, 4, 4, 1, 4, 0, 4, 1, 1, 4, 2, 1…
$ Atraso  <int> 0, 6, 0, 1, 6, 6, 1, 6, 6, 6, 6, 2, 6, 2, 6, 6, 6, 2, 6, 2, 0, 6, 6, 6, 6, 0, 6, 6, 0, 0, 6, 2, 2, 2, 0, 2, 2, 2, 6, 6, 0, 0, 0, 6, 2, 6…
$ Valor   <int> 5, 1, 2, 2, 0, 0, 2, 0, 0, 0, 0, 2, 0, 1, 0, 0, 1, 2, 0, 2, 1, 0, 0, 0, 0, 2, 0, 0, 1, 1, 0, 2, 0, 1, 1, 5, 1, 1, 0, 0, 5, 2, 1, 0, 1, 0…
$ CONTATO <int> 17, 10, 22, 8, 13, 11, 12, 8, 11, 9, 11, 9, 14, 11, 10, 9, 7, 22, 6, 12, 8, 12, 7, 13, 9, 7, 11, 23, 23, 3, 13, 11, 7, 5, 11, 13, 5, 10,…
$ EFETIVO <int> 2, 1, 1, 1, 1, 3, 1, 2, 1, 1, 1, 1, 3, 1, 1, 2, 1, 1, 1, 1, 1, 1, 1, 1, 2, 2, 1, 1, 1, 1, 2, 1, 1, 1, 1, 3, 1, 1, 2, 1, 1, 1, 1, 1, 2, 1…
$ Acordo  <int> 0, 1, 1, 1, 1, 1, 1, 0, 0, 1, 1, 1, 1, 0, 0, 1, 1, 1, 0, 0, 1, 1, 1, 1, 0, 0, 1, 1, 1, 1, 1, 1, 0, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 1, 1…
Faremos aqui então uma experimentação variando os números de clusters de 1 a 10 e printaremos aqui seus resultados:
- Iniciando com somente 1 cluster no algoritmo kmeans clustering:

- Agora com 2 clusters:

- Com 3 clusters:

Importante prestarmos atenção no valor da Soma dos Quadrados dos Erros…
- Com 4 clusters:

Podemos visualizar os clusters nas instâncias que fecham o acordo (azul) x as que não fecham (vermelho):

E finalmente, conforme mencionado pelo prof. na vídeo-aula, com k=7 esperamos o número ótimo de clusters:

O padrão dos clusters com as alterações no jitter para k = 7 ficam:

Note que como as escalas de cores não ficaram muito misturadas ainda, com k=7 para os que fecharam ou não acordo (acima e abaixo) notamos que com esse número ótimo de clusters (7), é possível distinguirmos com clareza os grupos.
Como recomendação do professor utilizaremos o k=15 e visualizaremos os resultados:

Notamos, que com k=15, a distinção entre os grupos fica mais difícil uma vez que o esquema de cores abaixo começa a se misturar em pelo menos em 3 gradações diferentes.
Estimativa do número ótimo de clusters no R
Para economizarmos tempo, executamos no R o gráfico do teste que nos demonstra qual seria o número ótimo de clusters no algoritmo K-Means: (na vídeo aula o professor comenta de k=7, para o RMS acumulado do modelo)
library(tidyverse)  # data manipulation
library(cluster)    # clustering algorithms
library(factoextra) # clustering algorithms & visualization
Rodando o algoritmo com k=7, temos a estimativa:
k7 <- kmeans(scale(A4), centers = 7, nstart = 25) # nstart = 25 fornece 25 configurações iniciais e fornece a ótima
str(k7)
List of 9
$ cluster : int [1:4773] 4 5 5 2 5 6 5 1 1 2 ...
$ centers : num [1:7, 1:6] 0.0872 1.5775 -0.4851 0.3048 -0.3829 ...
..- attr(*, "dimnames")=List of 2
.. ..$ : chr [1:7] "1" "2" "3" "4" ...
.. ..$ : chr [1:6] "Idade" "Atraso" "Valor" "CONTATO" ...
$ totss : num 28632
$ withinss : num [1:7] 2215 1047 641 2348 1338 ...
$ tot.withinss: num 11317
$ betweenss : num 17315
$ size : int [1:7] 657 611 679 534 377 551 1364
$ iter : int 3
$ ifault : int 0
- attr(*, "class")= chr "kmeans"Se printarmos os resultados veremos os agrupamentos dos 7 clusters de tamanhos 534 a 679:
k7K-means clustering with 7 clusters of sizes 657, 611, 679, 534, 377, 551, 1364
Cluster means:
Idade Atraso Valor CONTATO EFETIVO Acordo
1 0.08717118 -0.04444734 -0.1950311 0.00756035 -0.22166685 -2.1223210
2 1.57746938 0.07023504 -0.3483952 -0.38201019 -0.38744754 0.4710835
3 -0.48505052 1.55614590 -0.7424193 -0.28342953 -0.38744754 0.4710835
4 0.30484920 -0.70773191 2.3671078 0.20129125 -0.05329027 -0.4128109
5 -0.38292478 -0.19929928 -0.0335927 2.02833182 -0.22762669 0.3610186
6 0.02021449 0.21548247 -0.2629757 0.22721762 2.33791864 0.4146029
7 -0.52882769 -0.53959013 -0.1916157 -0.42263769 -0.38744754 0.4710835
Clustering vector:
[1] 4 5 5 2 5 6 5 1 1 2 5 5 6 1 1 6 3 5 1 1 5 5 3 5 1 1 5 5 5 2 6 5 1 7 5 6 2 5 6 5 4 5 1 1 5 3 3 1 2 5 6 1 6 5 3 5 3 6 6 5 3 6 4 5 1 6 1 6 1 6 5 5 3 4
[75] 5 5 5 2 4 5 2 6 1 5 1 3 4 1 6 5 5 5 3 4 6 1 5 6 5 4 5 1 5 6 6 6 4 2 5 2 5 4 5 6 2 5 7 7 1 6 5 6 5 3 5 5 5 6 1 5 4 1 1 6 1 5 5 4 3 3 2 4 4 5 7 6 6 5
[149] 1 7 7 4 6 1 6 4 5 6 3 7 5 7 6 3 6 5 5 6 4 2 5 1 7 4 7 1 5 5 4 7 3 2 7 7 5 6 3 1 6 4 4 5 1 3 1 2 2 3 5 3 6 5 3 3 3 1 1 3 4 5 1 1 7 7 1 5 4 3 5 5 6 6
[223] 6 6 6 7 6 7 1 5 6 1 6 5 6 3 6 4 3 6 5 1 3 3 7 3 5 4 7 4 4 1 4 4 1 6 6 6 5 6 2 3 7 7 3 3 4 7 7 6 7 7 1 3 1 7 6 5 4 2 2 5 7 2 7 6 3 5 3 7 3 3 3 3 5 6
[297] 7 5 7 6 7 3 7 4 6 7 1 5 7 5 5 7 4 7 3 5 7 4 6 3 3 7 3 3 5 6 6 3 3 3 7 7 7 6 5 7 3 7 4 2 4 4 6 5 1 3 3 7 2 2 7 5 4 5 7 3 7 3 5 6 3 7 1 7 5 3 3 5 4 6
[371] 7 3 7 3 3 5 5 3 7 6 5 5 1 7 7 2 5 3 4 4 7 5 6 7 6 2 4 4 2 2 6 5 2 3 6 2 2 4 7 1 4 7 1 6 3 5 5 5 7 4 6 6 2 7 4 3 2 2 1 2 2 4 3 2 3 1 2 2 4 4 1 1 1 2
[445] 7 6 7 5 5 7 7 5 2 6 2 2 4 4 3 2 7 5 4 6 7 2 6 7 2 3 2 6 2 7 7 4 5 7 6 4 2 4 6 5 7 1 3 1 5 5 3 2 1 4 7 6 1 6 3 5 3 6 6 5 7 6 3 5 5 2 7 6 6 7 6 7 5 4
[519] 6 7 6 3 3 4 5 7 6 6 6 6 5 2 5 1 2 1 4 6 6 4 3 3 3 5 6 3 1 7 4 6 6 7 6 6 3 5 7 5 5 7 6 6 7 1 1 3 3 6 6 7 7 2 7 6 2 7 7 3 1 6 3 5 1 5 2 2 7 1 3 3 3 3
[593] 6 7 3 2 2 7 1 1 3 7 5 1 7 4 3 5 1 1 2 5 7 2 3 3 5 6 6 2 1 3 4 7 6 3 3 3 6 2 4 4 6 7 7 1 1 4 5 6 6 6 6 2 7 1 2 3 2 5 7 7 7 7 7 5 5 3 7 6 3 3 7 4 6 5
[667] 6 5 3 1 1 3 7 1 2 2 5 2 3 3 7 3 7 6 6 4 1 7 5 4 6 4 7 5 6 7 7 7 7 3 1 6 7 7 1 6 7 7 2 4 7 1 2 1 7 7 2 3 1 1 7 6 7 4 5 5 5 7 1 1 5 7 6 5 7 2 7 2 6 4
[741] 6 4 4 2 5 5 4 6 5 4 6 5 4 7 3 7 7 4 6 6 5 3 4 3 1 7 4 3 5 5 7 1 3 5 2 7 7 3 3 6 7 3 6 1 1 5 6 3 7 5 2 7 3 2 7 7 2 6 2 2 7 7 7 7 6 7 7 7 6 5 1 7 1 2
[815] 4 5 6 2 5 5 3 7 7 2 6 3 6 6 5 7 5 6 1 6 2 5 1 5 4 6 4 4 6 3 1 5 3 7 6 6 7 7 2 3 7 3 5 5 2 2 2 5 2 7 5 2 4 4 7 1 6 5 7 2 3 1 3 5 3 5 5 6 7 4 5 2 3 4
[889] 6 2 4 4 7 6 5 5 3 1 7 1 7 1 2 4 7 5 6 4 4 6 2 7 2 6 4 2 6 2 2 4 3 1 6 6 3 6 7 2 5 1 5 4 4 5 6 7 5 3 2 7 4 2 7 3 7 3 7 5 5 4 4 4 7 6 2 7 1 7 7 1 3 2
[963] 6 5 2 7 5 3 4 6 4 4 7 4 2 4 6 2 7 1 7 7 6 7 2 1 6 3 3 3 7 6 7 4 7 3 2 4 3 1
[ reached getOption("max.print") -- omitted 3773 entries ]
Within cluster sum of squares by cluster:
[1] 2215.0713 1047.3421 641.1397 2348.2339 1337.7905 2439.7066 1288.0519
(between_SS / total_SS = 60.5 %)
Available components:
[1] "cluster" "centers" "totss" "withinss" "tot.withinss" "betweenss" "size" "iter" "ifault" Vemos os centros de cluster (médias) para os sete grupos nas seis variáveis (Idade, Atraso, Valor, CONTATO, EFETIVO, Acordo). Também obtemos a atribuição de cluster para cada observação (ou seja, a obs 1 foi atribuído ao cluster a, a obs 2 foi atribuído ao cluster 6, a terceira no cluster 6, a quarta no 2 e assim sucessivamente).
Também podemos visualizar nossos resultados usando
fviz_cluster. Isso fornece uma boa ilustração dos clusters.
Se houver mais de duas dimensões (variáveis), o
fviz_cluster realizará a análise de componentes principais
(PCA) e plotará os pontos de dados de acordo com os dois primeiros
componentes principais que explicam a maior parte da variância.
ggplotly(
fviz_cluster(k7, data = scale(A4))
)
Como o número de clusters (k) deve ser definido antes de iniciarmos o algoritmo, geralmente é vantajoso usar vários valores diferentes de k e examinar as diferenças nos resultados. Podemos executar o mesmo processo para 6, 7 e 8 clusters, e os resultados são mostrados na figura:
k5 <- kmeans(scale(A4), centers = 5, nstart = 25)
k6 <- kmeans(scale(A4), centers = 6, nstart = 25)
k7 <- kmeans(scale(A4), centers = 7, nstart = 25)
k8 <- kmeans(scale(A4), centers = 8, nstart = 25)

# plots to compare
p1 <- fviz_cluster(k5, geom = "point",  data = scale(A4)) + ggtitle("k = 5")
p2 <- fviz_cluster(k6, geom = "point",  data = scale(A4)) + ggtitle("k = 6")
p3 <- fviz_cluster(k7, geom = "point",  data = scale(A4)) + ggtitle("k = 7")
p4 <- fviz_cluster(k8, geom = "point",  data = scale(A4)) + ggtitle("k = 8")

library(gridExtra)
grid.arrange(p1, p2, p3, p4, nrow = 2)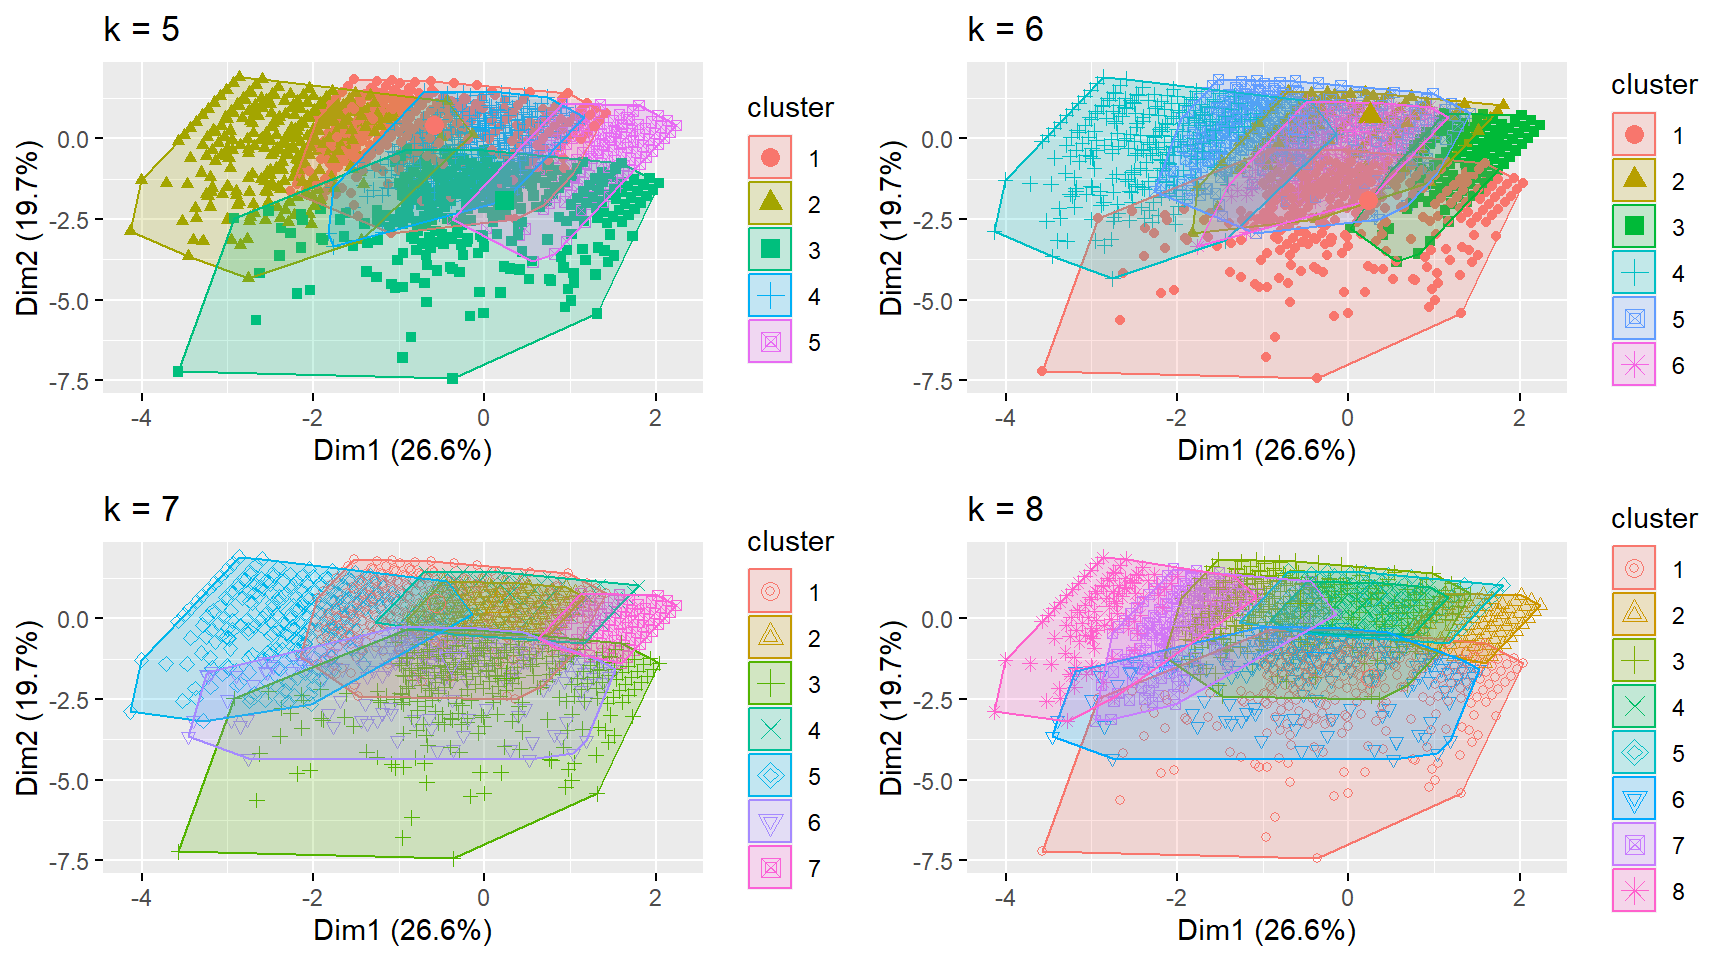
Embora essa avaliação visual nos diga onde ocorrem as verdadeiras dilineações (ou não ocorrem, como os clusters 2 e 4 no gráfico k = 8) entre os clusters, ela não nos diz qual é o número ideal de clusters.
O conhecido gráfico de cotovelo estimado pela expressão:
\[ minimizar\Bigg(\sum^k_{k=1}W(C_k)\Bigg) \tag{equação cotovelo} \]
onde \(C_k = k-\)ésimo cluster e o \(W(C_k)\) a variação intra-cluster. A soma do quadrado total dentro do cluster (wss) mede a compacidade do cluster e o que esperamos que seja o menor possível.
set.seed(123)

# função para obter o total de soma quadrática intra-clusters
wss <- function(k) {
  kmeans(scale(A4), k, nstart = 10 )$tot.withinss
}

k.values <- 1:15

# extrai wss para os clusters 2 a 15

wss_values <- map_dbl(k.values, wss)

as_tibble(wss_values)
set.seed(123)
fviz_nbclust(scale(A4), kmeans, method = "wss")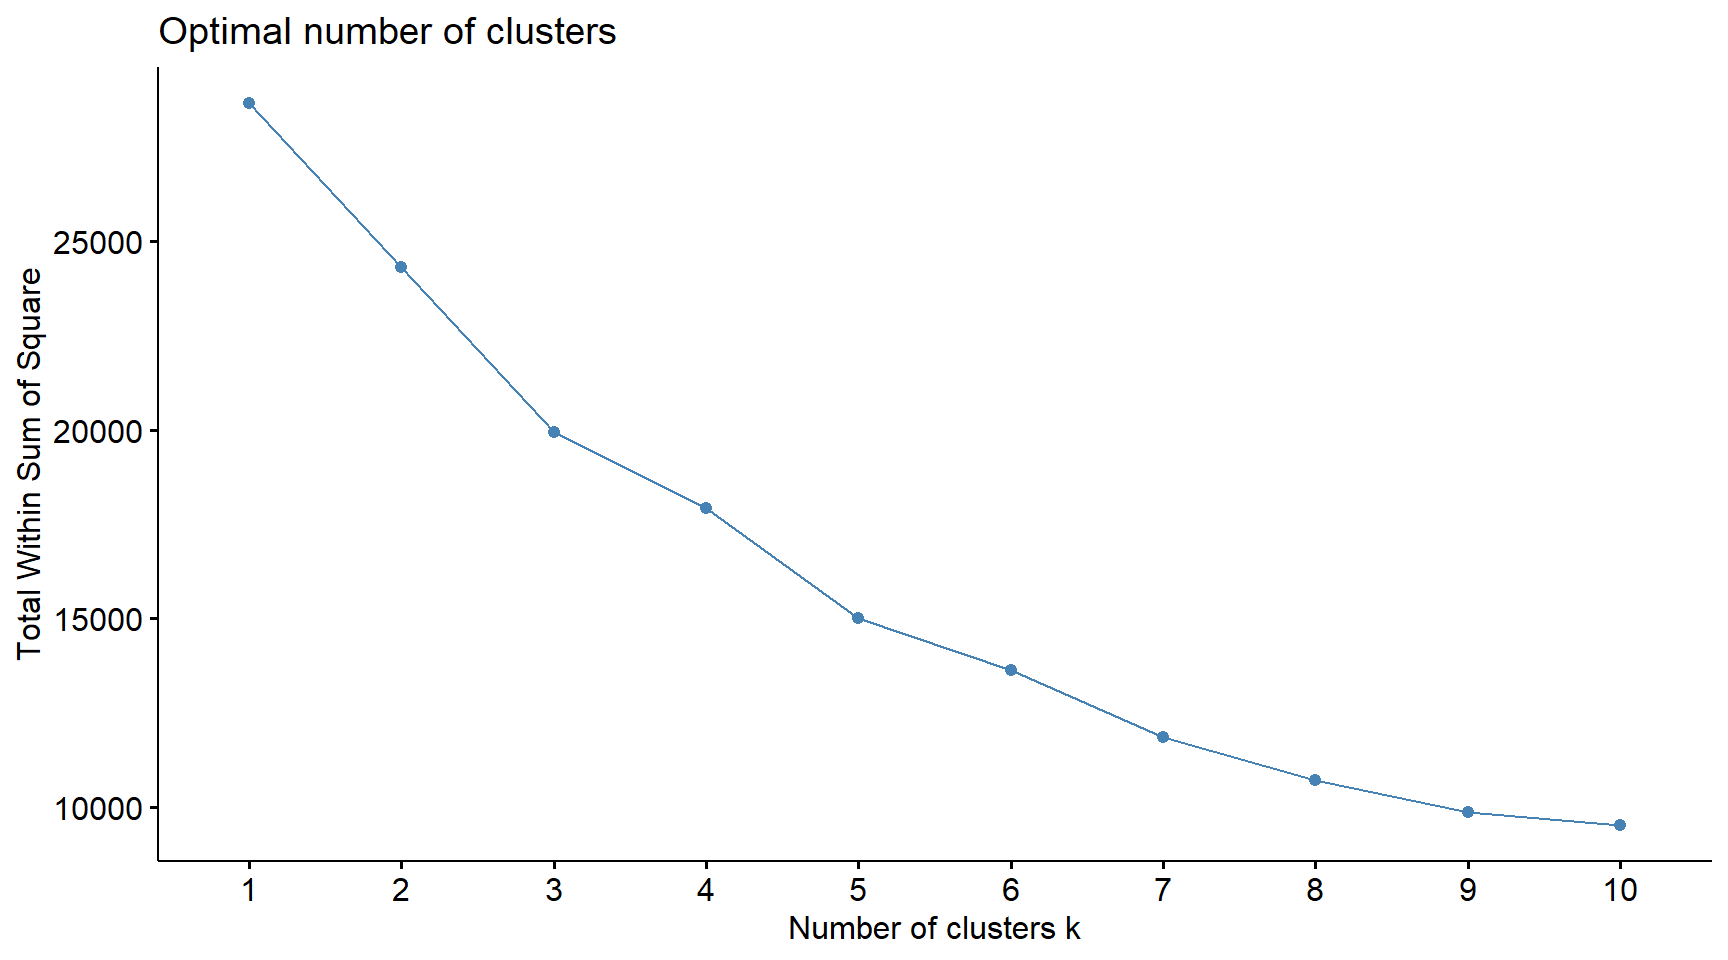
Como visto no gráfico acima ainda não nos parece tão nítido qual seria o ponto visualmente identificável da quebra do cotovelo. Utilizaremos a conhecida abordagem de silhueta média para tal procedimento.
Resumidamente, a abordagem de silhueta média mede a qualidade de um agrupamento. Ou seja, determina quão bem cada objeto está dentro de seu cluster. Uma largura de silhueta média alta indica um bom agrupamento. O método da silhueta média calcula a silhueta média das observações para diferentes valores de \(k\). O número ótimo de clusters \(k\) é aquele que maximiza a silhueta média em um intervalo de valores possíveis para \(k\).
fviz_nbclust(scale(A4), kmeans, method = "silhouette")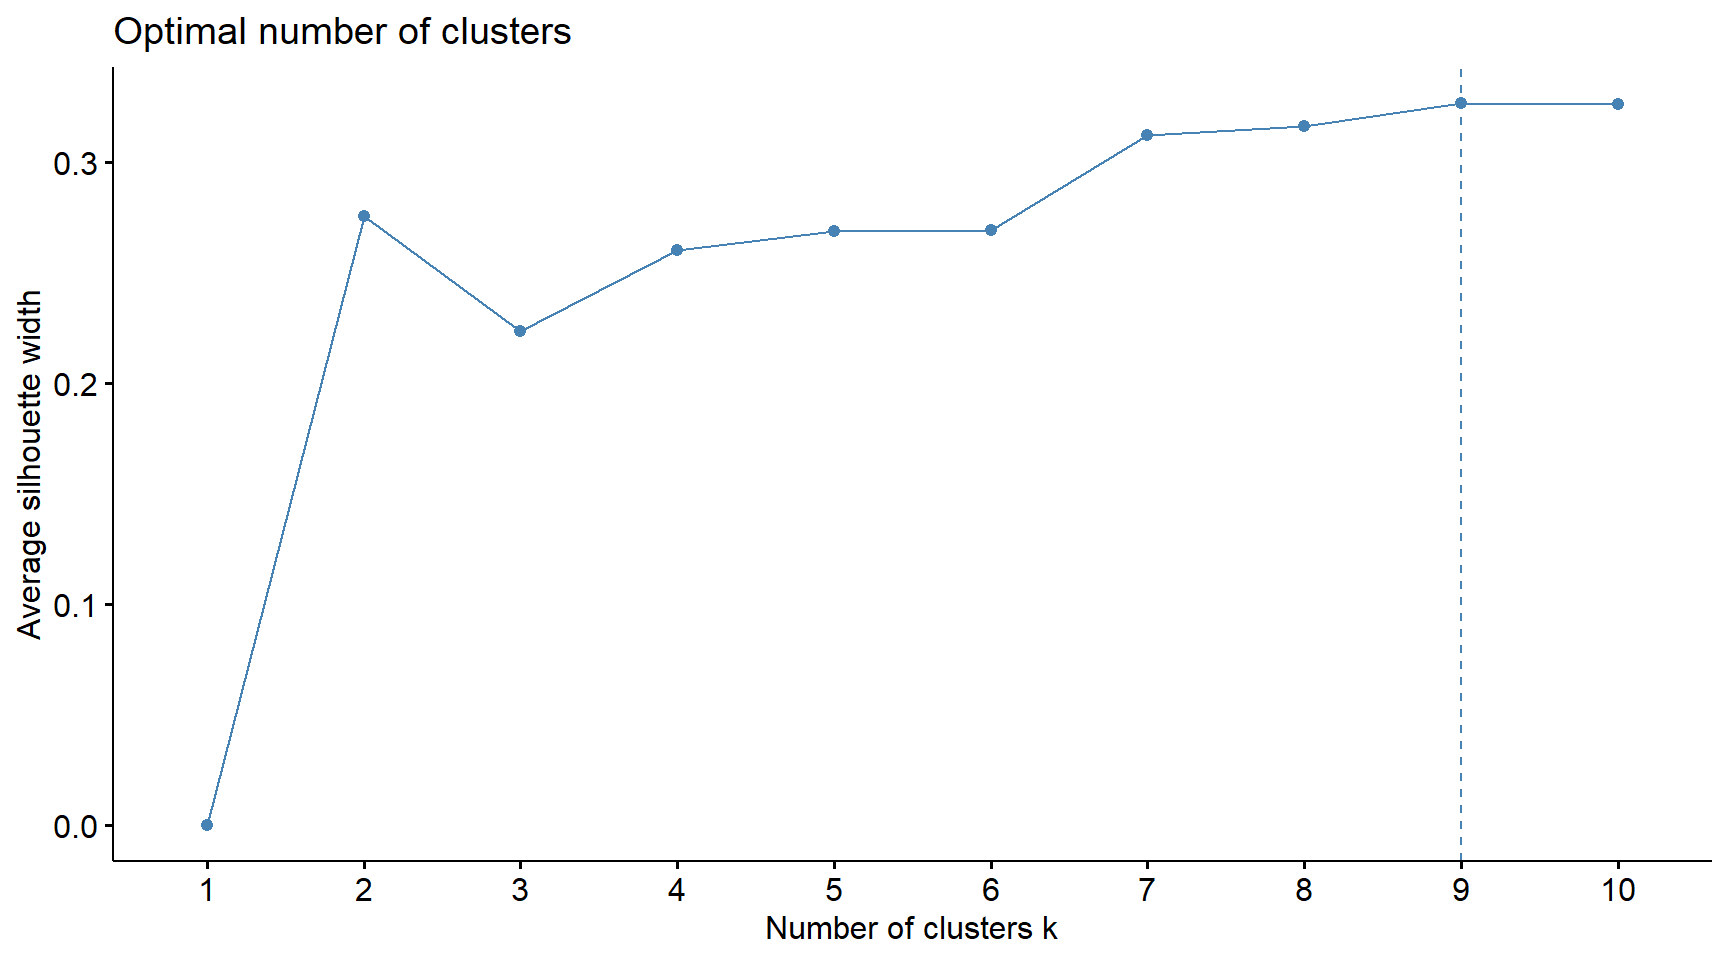
Visualizando os resultados nos clusters com o k sugerido temos:
final <- kmeans(scale(A4), 9, nstart = 25)

fviz_cluster(final, data = scale(A4))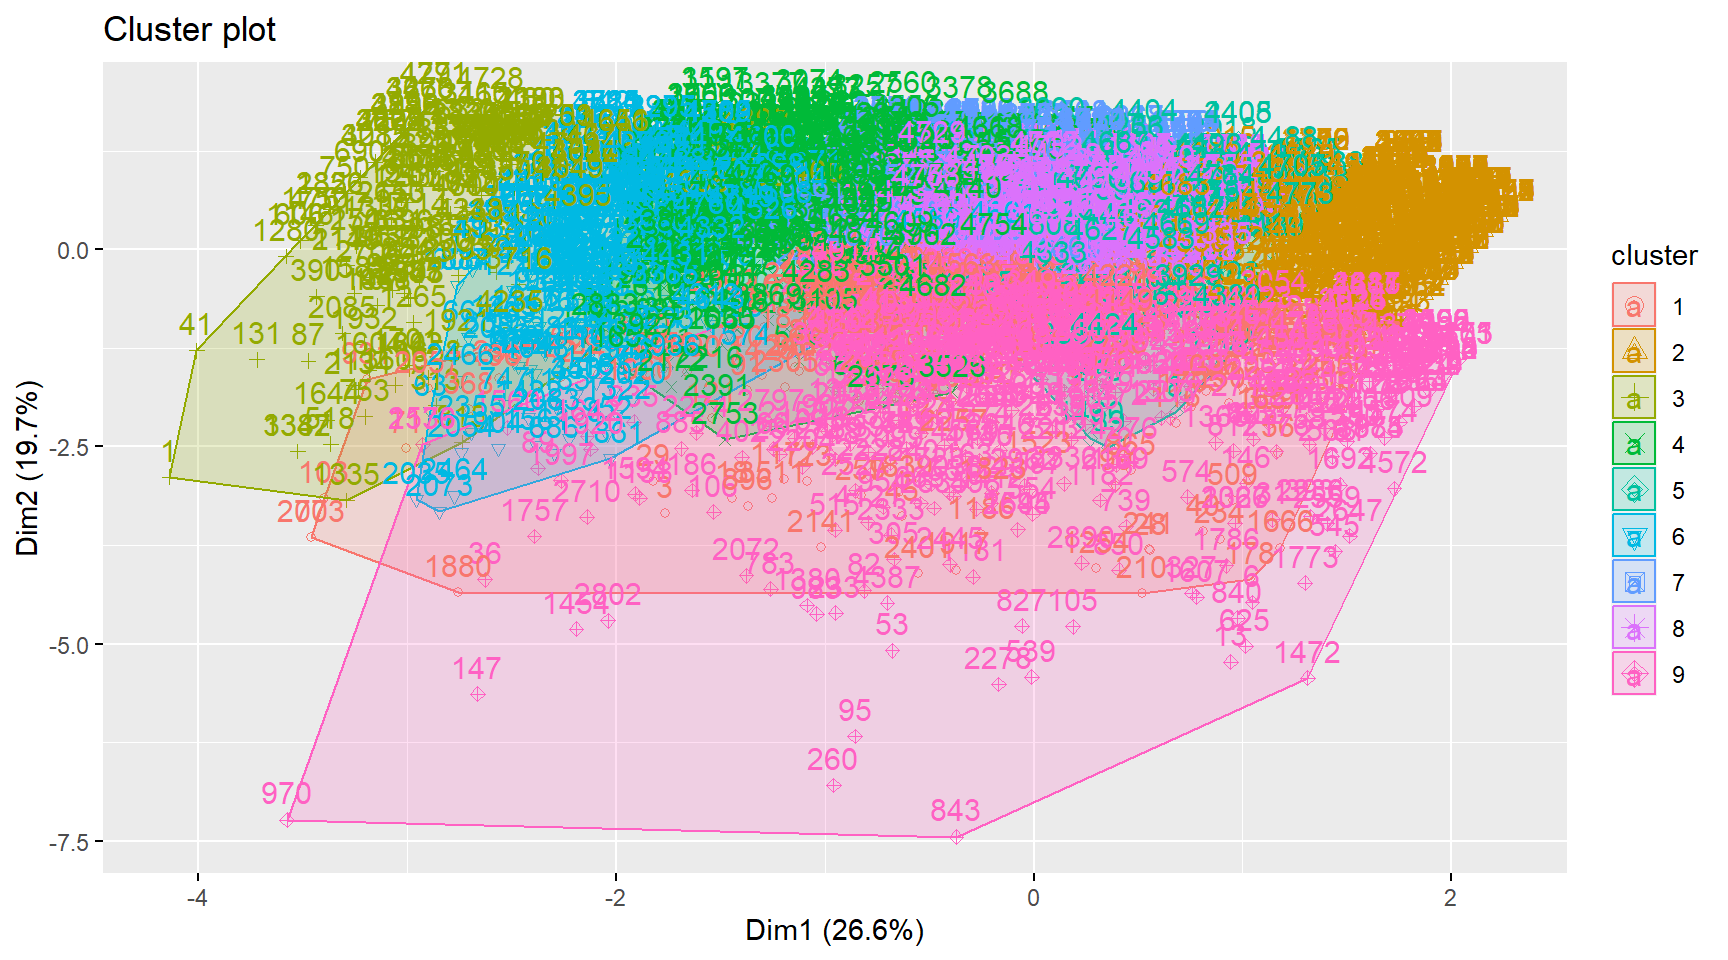
E podemos extrair os clusters e adicionar aos nossos dados iniciais para fazer algumas estatísticas descritivas no nível do cluster:
A4 %>%
  mutate(Cluster = final$cluster) %>%
  group_by(Cluster) %>%
  summarise_all("mean")
Exercício 1
Para rodarmos o algoritmo apriori no Weka fazemos a seleção do
arquivo de exemplo do Weka contact-lenses.ARFF localmente e
então optamos pelos algoritmos de associção na aba conforme demonstram
as figuras a seguir:

Como optamos por utilizar outro dataset e não o A4.csv
para rodarmos o algoritmo apriori apontaremos as principais formas de
interpretações dos resultados gerados por esse algoritmo de
associação:

Como todas as variáveis/atributos aqui não são numéricas, selecionamos na aba Associate o algoritmo apriori:

O output gerado após darmos Ok na tela anterior e clicarmos em Start pelo Weka é:
=== Run information ===

Scheme:       weka.associations.Apriori -N 10 -T 0 -C 0.9 -D 0.05 -U 1.0 -M 0.1 -S -1.0 -c -1
Relation:     contact-lenses
Instances:    24
Attributes:   5
              age
              spectacle-prescrip
              astigmatism
              tear-prod-rate
              contact-lenses
=== Associator model (full training set) ===


Apriori
=======

Minimum support: 0.2 (5 instances)
Minimum metric <confidence>: 0.9
Number of cycles performed: 16

Generated sets of large itemsets:

Size of set of large itemsets L(1): 11

Size of set of large itemsets L(2): 21

Size of set of large itemsets L(3): 6

Best rules found:

 1. tear-prod-rate=reduced 12 ==> contact-lenses=none 12    <conf:(1)> lift:(1.6) lev:(0.19) [4] conv:(4.5)
 2. spectacle-prescrip=myope tear-prod-rate=reduced 6 ==> contact-lenses=none 6    <conf:(1)> lift:(1.6) lev:(0.09) [2] conv:(2.25)
 3. spectacle-prescrip=hypermetrope tear-prod-rate=reduced 6 ==> contact-lenses=none 6    <conf:(1)> lift:(1.6) lev:(0.09) [2] conv:(2.25)
 4. astigmatism=no tear-prod-rate=reduced 6 ==> contact-lenses=none 6    <conf:(1)> lift:(1.6) lev:(0.09) [2] conv:(2.25)
 5. astigmatism=yes tear-prod-rate=reduced 6 ==> contact-lenses=none 6    <conf:(1)> lift:(1.6) lev:(0.09) [2] conv:(2.25)
 6. contact-lenses=soft 5 ==> astigmatism=no 5    <conf:(1)> lift:(2) lev:(0.1) [2] conv:(2.5)
 7. contact-lenses=soft 5 ==> tear-prod-rate=normal 5    <conf:(1)> lift:(2) lev:(0.1) [2] conv:(2.5)
 8. tear-prod-rate=normal contact-lenses=soft 5 ==> astigmatism=no 5    <conf:(1)> lift:(2) lev:(0.1) [2] conv:(2.5)
 9. astigmatism=no contact-lenses=soft 5 ==> tear-prod-rate=normal 5    <conf:(1)> lift:(2) lev:(0.1) [2] conv:(2.5)
10. contact-lenses=soft 5 ==> astigmatism=no tear-prod-rate=normal 5    <conf:(1)> lift:(4) lev:(0.16) [3] conv:(3.75)
O print do Weka segue:

Vamos nos atentar ao final do output gerado pelo apriori nas regras de associação.
Best rules found:

 1. tear-prod-rate=reduced 12 ==> contact-lenses=none 12    <conf:(1)> lift:(1.6) lev:(0.19) [4] conv:(4.5)
 2. spectacle-prescrip=myope tear-prod-rate=reduced 6 ==> contact-lenses=none 6    <conf:(1)> lift:(1.6) lev:(0.09) [2] conv:(2.25)
 3. spectacle-prescrip=hypermetrope tear-prod-rate=reduced 6 ==> contact-lenses=none 6    <conf:(1)> lift:(1.6) lev:(0.09) [2] conv:(2.25)
 4. astigmatism=no tear-prod-rate=reduced 6 ==> contact-lenses=none 6    <conf:(1)> lift:(1.6) lev:(0.09) [2] conv:(2.25)
 5. astigmatism=yes tear-prod-rate=reduced 6 ==> contact-lenses=none 6    <conf:(1)> lift:(1.6) lev:(0.09) [2] conv:(2.25)
 6. contact-lenses=soft 5 ==> astigmatism=no 5    <conf:(1)> lift:(2) lev:(0.1) [2] conv:(2.5)
 7. contact-lenses=soft 5 ==> tear-prod-rate=normal 5    <conf:(1)> lift:(2) lev:(0.1) [2] conv:(2.5)
 8. tear-prod-rate=normal contact-lenses=soft 5 ==> astigmatism=no 5    <conf:(1)> lift:(2) lev:(0.1) [2] conv:(2.5)
 9. astigmatism=no contact-lenses=soft 5 ==> tear-prod-rate=normal 5    <conf:(1)> lift:(2) lev:(0.1) [2] conv:(2.5)
10. contact-lenses=soft 5 ==> astigmatism=no tear-prod-rate=normal 5    <conf:(1)> lift:(4) lev:(0.16) [3] conv:(3.75)
Se tormarmos a primeira regra de associação que nos mostra que
1. tear-prod-rate=reduced 12 ==> contact-lenses=none 12 <conf:(1)> lift:(1.6) lev:(0.19) [4] conv:(4.5)A tear-production está basicamente dizendo que se
encontrarmos que se ela for reduzida então 12 dessas instâncias não
terão consequências em contact-lenses.
Então há uma associação notável para observarmos; e 12 sendo quase metade desse conjunto de dados é realmente impactante no todo. Assim podemos ver a associação a ser classificada e com grau de confiança temos .1 uma vez que estão classificadas por nível de confiança, podemos ver que concordamos totalmente e achamos que está correto.
Utilizando o algoritmo apriori em Market Basket Analisys
O algoritmo apriori é usado para encontrar conjuntos de itens frequentes em um conjunto de dados para mineração de regras de associação. Chama-se Apriori porque usa o conhecimento prévio das propriedades frequentes do conjunto de itens. Aplicamos uma abordagem iterativa ou busca em nível em que conjuntos de itens k-frequentes são usados para encontrar conjuntos de itens k+1.
Para melhorar a eficiência da geração de conjuntos de itens frequentes, uma propriedade importante é usada, chamada de propriedade Apriori, que ajuda a reduzir o espaço de busca.
Propriedade Apriori: Todos os subconjuntos não vazios de um conjunto de itens frequente devem ser frequentes. Apriori assume que todos os subconjuntos de um itemset frequente devem ser frequentes (propriedade Apriori). Se um conjunto de itens for infrequente, todos os seus superconjuntos serão infrequentes.
Essencialmente, o algoritmo Apriori pega cada parte de um conjunto de dados maior e o contrasta com outros conjuntos de alguma forma ordenada. As pontuações resultantes são usadas para gerar conjuntos que são classificados como aparências frequentes em um banco de dados maior para coleta de dados agregados. Em um sentido prático, pode-se ter uma ideia melhor do algoritmo olhando para aplicativos como uma Ferramenta de Cesta de Mercado que ajuda a descobrir quais itens são comprados juntos em uma cesta de mercado, ou uma ferramenta de análise financeira que ajuda a mostrar como vários ações tendem juntos. O algoritmo Apriori pode ser usado em conjunto com outros algoritmos para classificar e contrastar dados de forma eficaz para mostrar uma imagem muito melhor de como sistemas complexos refletem padrões e tendências.
library(arules)
library(arulesViz)
library(RColorBrewer)
O dataset Groceries possui dados referentes a cestas de
consumo de alimentos e compras em supermercados:
data("Groceries")

summary(Groceries)
transactions as itemMatrix in sparse format with
9835 rows (elements/itemsets/transactions) and
169 columns (items) and a density of 0.02609146
most frequent items:
whole milk other vegetables rolls/buns soda yogurt (Other)
2513 1903 1809 1715 1372 34055
element (itemset/transaction) length distribution:
sizes
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 26 27 28 29 32
2159 1643 1299 1005 855 645 545 438 350 246 182 117 78 77 55 46 29 14 14 9 11 4 6 1 1 1 1 3 1
Min. 1st Qu. Median Mean 3rd Qu. Max.
1.000 2.000 3.000 4.409 6.000 32.000
includes extended item information - examples:
labels level2 level1
1 frankfurter sausage meat and sausage
2 sausage sausage meat and sausage
3 liver loaf sausage meat and sausageGroceries@itemInfo[1:20,]Como esse dataset nos fornece as transações de um produto a outro, veremos com o código a seguir da 10ª a 20ª tranção do conjunto de dados Groceries.
apply(Groceries@data[,10:20],2,function(r) paste(Groceries@itemInfo[r,"labels"],collapse=", ")) [1] "whole milk, cereals"
[2] "tropical fruit, other vegetables, white bread, bottled water, chocolate"
[3] "citrus fruit, tropical fruit, whole milk, butter, curd, yogurt, flour, bottled water, dishes"
[4] "beef"
[5] "frankfurter, rolls/buns, soda"
[6] "chicken, tropical fruit"
[7] "butter, sugar, fruit/vegetable juice, newspapers"
[8] "fruit/vegetable juice"
[9] "packaged fruit/vegetables"
[10] "chocolate"
[11] "specialty bar" A função apriori() está embutida no R para minerar
conjuntos de itens frequentes e regras de associação usando o algoritmo
Apriori. Aqui, Groceries são os dados da transação.
parameter é uma lista nomeada que especifica o suporte e os
mínimos graus de confiança para localizar as regras de associação. O
comportamento padrão é minerar as regras com suporte mínimo de 0,1 e 0,8
como a confiança mínima.
regras <- apriori(Groceries, parameter = list(support=0.001, confidence=0.6, target="rules"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target ext
0.6 0.1 1 none FALSE TRUE 5 0.001 1 10 rules TRUE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 9
set item appearances ...[0 item(s)] done [0.00s].
set transactions ...[169 item(s), 9835 transaction(s)] done [0.01s].
sorting and recoding items ... [157 item(s)] done [0.00s].
creating transaction tree ... done [0.00s].
checking subsets of size 1 2 3 4 5 6 done [0.02s].
writing ... [2918 rule(s)] done [0.00s].
creating S4 object ... done [0.00s].summary(regras)set of 2918 rules
rule length distribution (lhs + rhs):sizes
2 3 4 5 6
3 490 1765 626 34
Min. 1st Qu. Median Mean 3rd Qu. Max.
2.000 4.000 4.000 4.068 4.000 6.000
summary of quality measures:
support confidence coverage lift count
Min. :0.001017 Min. :0.6000 Min. :0.001017 Min. : 2.348 Min. :10.00
1st Qu.:0.001118 1st Qu.:0.6316 1st Qu.:0.001525 1st Qu.: 2.668 1st Qu.:11.00
Median :0.001220 Median :0.6818 Median :0.001830 Median : 3.168 Median :12.00
Mean :0.001480 Mean :0.7028 Mean :0.002157 Mean : 3.450 Mean :14.55
3rd Qu.:0.001525 3rd Qu.:0.7500 3rd Qu.:0.002339 3rd Qu.: 3.692 3rd Qu.:15.00
Max. :0.009354 Max. :1.0000 Max. :0.014642 Max. :18.996 Max. :92.00
mining info:
data ntransactions support confidence call
Groceries 9835 0.001 0.6 apriori(data = Groceries, parameter = list(support = 0.001, confidence = 0.6, target = "rules"))Vejamos quais as configurações transacionais por item:
conf_itens <- apriori(Groceries, parameter = list(minlen = 1, maxlen = 1, support = 0.02, target = "frequent itemsets"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target ext
NA 0.1 1 none FALSE TRUE 5 0.02 1 1 frequent itemsets TRUE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 196
set item appearances ...[0 item(s)] done [0.00s].
set transactions ...[169 item(s), 9835 transaction(s)] done [0.00s].
sorting and recoding items ... [59 item(s)] done [0.00s].
creating transaction tree ... done [0.00s].
checking subsets of size 1 done [0.00s].
sorting transactions ... done [0.00s].
writing ... [59 set(s)] done [0.00s].
creating S4 object ... done [0.00s].summary(conf_itens) # Encontrou 59 configuraçõesset of 59 itemsets
most frequent items:
frankfurter sausage ham meat chicken (Other)
1 1 1 1 1 54
element (itemset/transaction) length distribution:sizes
1
59
Min. 1st Qu. Median Mean 3rd Qu. Max.
1 1 1 1 1 1
summary of quality measures:
support count
Min. :0.02105 Min. : 207.0
1st Qu.:0.03015 1st Qu.: 296.5
Median :0.04809 Median : 473.0
Mean :0.06200 Mean : 609.8
3rd Qu.:0.07666 3rd Qu.: 754.0
Max. :0.25552 Max. :2513.0
includes transaction ID lists: FALSE
mining info:
data ntransactions support confidence
Groceries 9835 0.02 1
call
apriori(data = Groceries, parameter = list(minlen = 1, maxlen = 1, support = 0.02, target = "frequent itemsets"))inspect(head(sort(conf_itens, by = "support"), 10)) # Lista os top 10 items support count
[1] {whole milk} 0.25551601 2513
[2] {other vegetables} 0.19349263 1903
[3] {rolls/buns} 0.18393493 1809
[4] {soda} 0.17437722 1715
[5] {yogurt} 0.13950178 1372
[6] {bottled water} 0.11052364 1087
[7] {root vegetables} 0.10899847 1072
[8] {tropical fruit} 0.10493137 1032
[9] {shopping bags} 0.09852567 969
[10] {sausage} 0.09395018 924 A função inspect() fornece a representação interna de um
objeto R ou o resultado de uma expressão. Aqui, ele exibe as primeiras
10 regras de associação mais fortes.
inspect(head(sort(regras, by="support"), 10)) lhs rhs support confidence coverage lift count
[1] {butter, yogurt} => {whole milk} 0.009354347 0.6388889 0.014641586 2.500387 92
[2] {root vegetables, butter} => {whole milk} 0.008235892 0.6377953 0.012913066 2.496107 81
[3] {root vegetables, other vegetables, yogurt} => {whole milk} 0.007829181 0.6062992 0.012913066 2.372842 77
[4] {tropical fruit, other vegetables, yogurt} => {whole milk} 0.007625826 0.6198347 0.012302999 2.425816 75
[5] {tropical fruit, domestic eggs} => {whole milk} 0.006914082 0.6071429 0.011387900 2.376144 68
[6] {butter, whipped/sour cream} => {whole milk} 0.006710727 0.6600000 0.010167768 2.583008 66
[7] {tropical fruit, curd} => {whole milk} 0.006507372 0.6336634 0.010269446 2.479936 64
[8] {tropical fruit, butter} => {whole milk} 0.006202339 0.6224490 0.009964413 2.436047 61
[9] {butter, domestic eggs} => {whole milk} 0.005998983 0.6210526 0.009659380 2.430582 59
[10] {pip fruit, whipped/sour cream} => {whole milk} 0.005998983 0.6483516 0.009252669 2.537421 59 itemFrequencyPlot() cria um gráfico de barras para
frequências de itens/suporte. Ele cria um gráfico de barras de
frequência de itens para inspecionar a distribuição de objetos com base
nas transações. Os itens são plotados ordenados por suporte decrescente.
Aqui, topN=20 significa que 20 itens com a maior
frequência/elevação de itens serão plotados.
arules::itemFrequencyPlot(Groceries, topN = 20,
                          col = brewer.pal(8, 'Pastel2'),
                          main = 'Gráfico de Frequência Relativa do Item',
                          tipo = "relativo",
                          ylab = "Frequência do item (relativa)")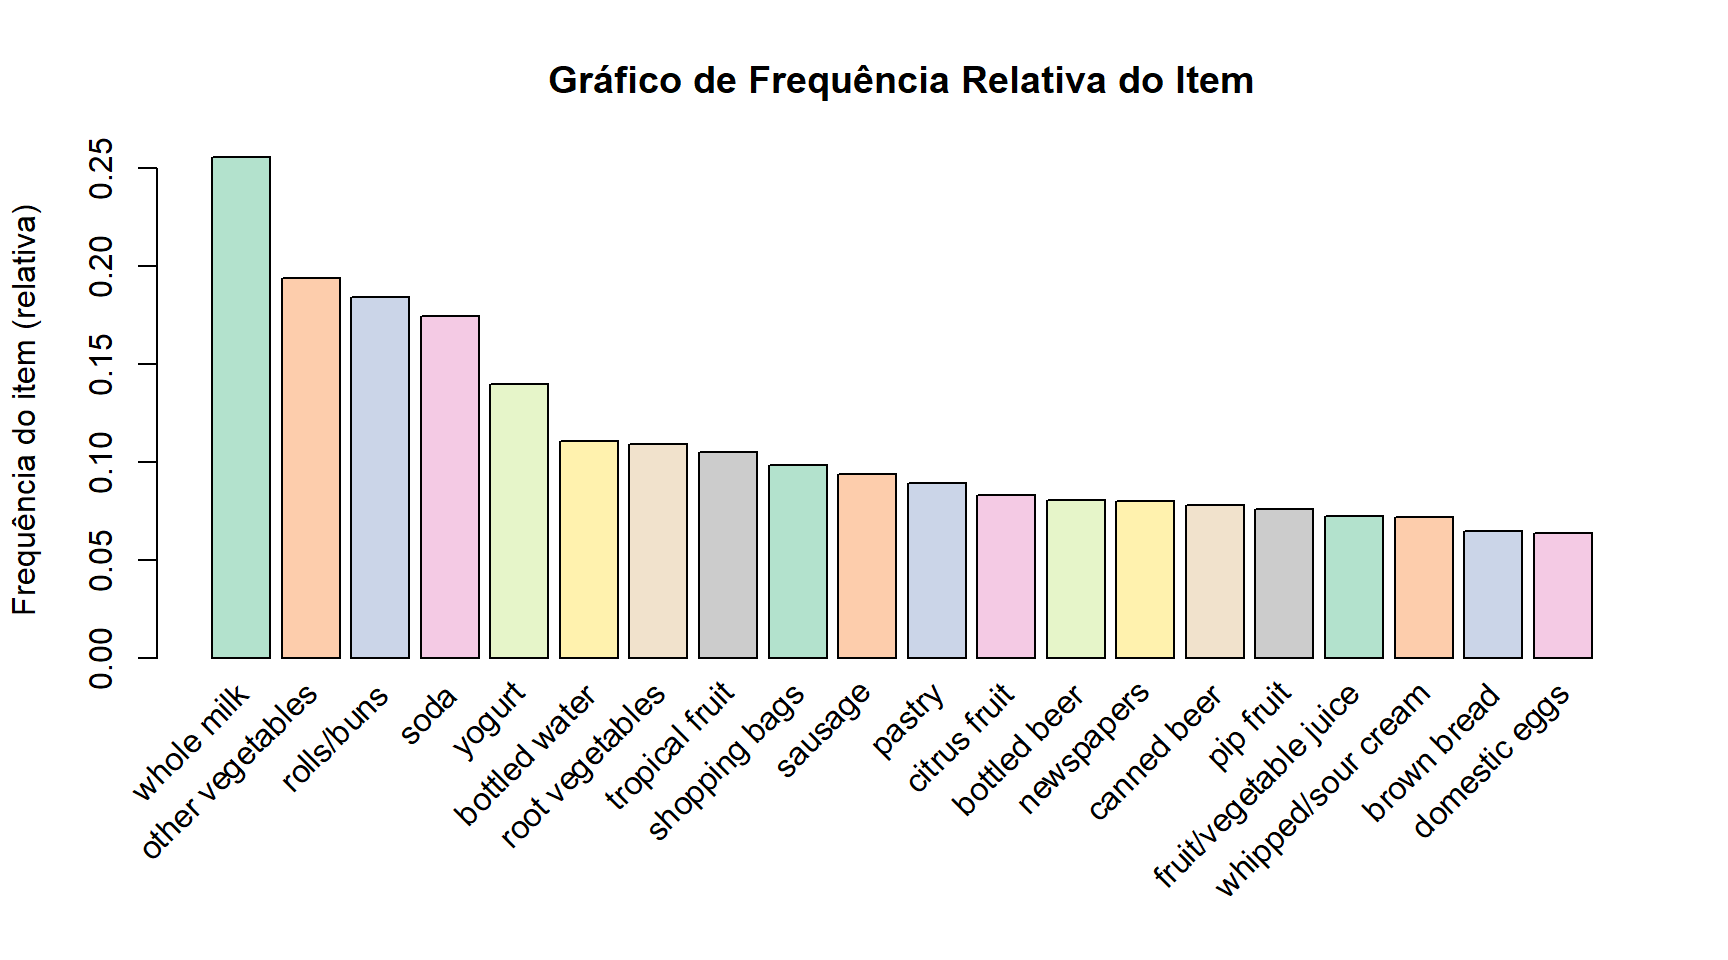
Também podemos gerar um scatterplot dos dados:
plot(regras) 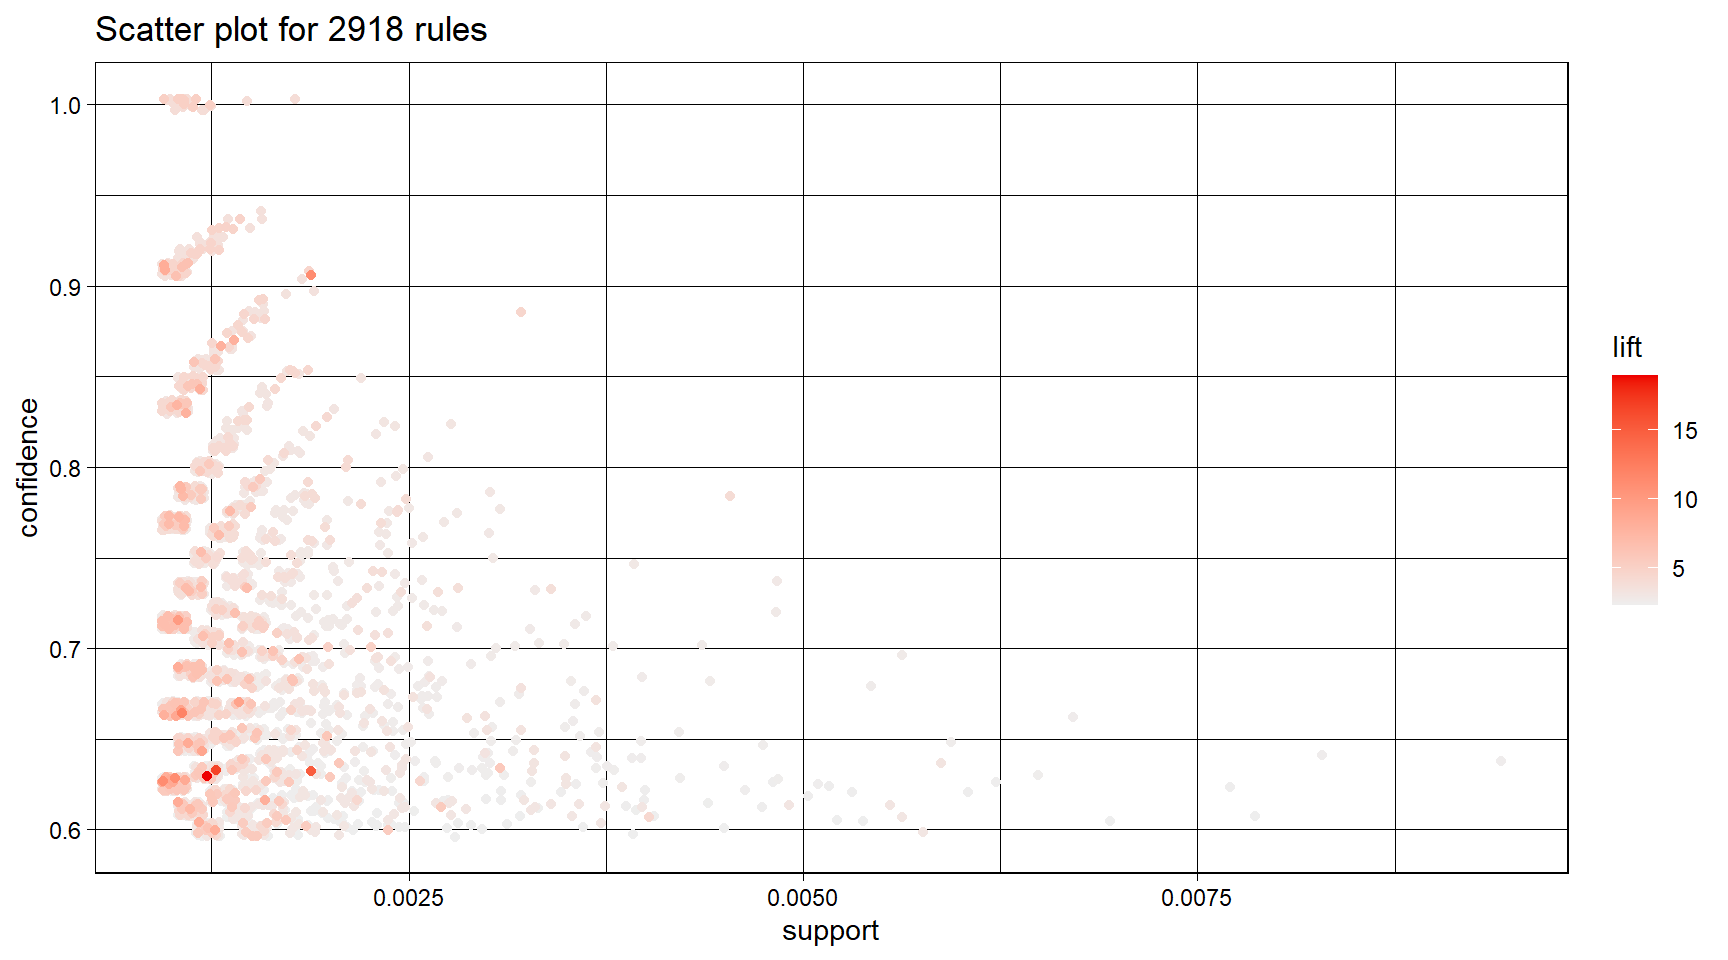
A função inspect é usada para exibir as 10 principais
regras classificadas por aumento (lift)
inspect(head(sort(regras, by="lift"), 10)) lhs rhs support confidence coverage lift count
[1] {Instant food products, soda} => {hamburger meat} 0.001220132 0.6315789 0.001931876 18.995654 12
[2] {soda, popcorn} => {salty snack} 0.001220132 0.6315789 0.001931876 16.697793 12
[3] {ham, processed cheese} => {white bread} 0.001931876 0.6333333 0.003050330 15.045491 19
[4] {tropical fruit, other vegetables, yogurt, white bread} => {butter} 0.001016777 0.6666667 0.001525165 12.030581 10
[5] {hamburger meat, yogurt, whipped/sour cream} => {butter} 0.001016777 0.6250000 0.001626843 11.278670 10
[6] {tropical fruit, other vegetables, whole milk, yogurt, domestic eggs} => {butter} 0.001016777 0.6250000 0.001626843 11.278670 10
[7] {liquor, red/blush wine} => {bottled beer} 0.001931876 0.9047619 0.002135231 11.235269 19
[8] {other vegetables, butter, sugar} => {whipped/sour cream} 0.001016777 0.7142857 0.001423488 9.964539 10
[9] {whole milk, butter, hard cheese} => {whipped/sour cream} 0.001423488 0.6666667 0.002135231 9.300236 14
[10] {tropical fruit, other vegetables, butter, fruit/vegetable juice} => {whipped/sour cream} 0.001016777 0.6666667 0.001525165 9.300236 10 regras <- apriori(Groceries, parameter = list(support=0.001, confidence=0.6, target = "rules")) # Redimensiona as regras para targetApriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target ext
0.6 0.1 1 none FALSE TRUE 5 0.001 1 10 rules TRUE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 9
set item appearances ...[0 item(s)] done [0.00s].
set transactions ...[169 item(s), 9835 transaction(s)] done [0.00s].
sorting and recoding items ... [157 item(s)] done [0.00s].
creating transaction tree ... done [0.00s].
checking subsets of size 1 2 3 4 5 6 done [0.01s].
writing ... [2918 rule(s)] done [0.00s].
creating S4 object ... done [0.00s].Abaixo do código busca regras com confiança acima de 0,9
regras_conf <- regras[quality(regras)$confidence > 0.9] Plota uma visualização baseada em matriz do LHS vs RHS de regras. Isso produz uma visualização baseada em matriz de LHS e RHS, colorida por elevação (lift) e confiança,
plot(regras_conf, method = "matrix", measure = c("lift", "confidence"), control = list(reorder="none"))Itemsets in Antecedent (LHS)
[1] "{liquor,red/blush wine}" "{curd,cereals}"
[3] "{soups,bottled beer}" "{whipped/sour cream,house keeping products}"
[5] "{pastry,sweet spreads}" "{rice,sugar}"
[7] "{rice,bottled water}" "{canned fish,hygiene articles}"
[9] "{grapes,onions}" "{hard cheese,oil}"
[11] "{root vegetables,butter,rice}" "{herbs,whole milk,fruit/vegetable juice}"
[13] "{citrus fruit,tropical fruit,herbs}" "{root vegetables,whipped/sour cream,flour}"
[15] "{butter,soft cheese,domestic eggs}" "{tropical fruit,whipped/sour cream,soft cheese}"
[17] "{root vegetables,whipped/sour cream,soft cheese}" "{citrus fruit,root vegetables,soft cheese}"
[19] "{frankfurter,tropical fruit,frozen meals}" "{tropical fruit,butter,frozen meals}"
[21] "{tropical fruit,whipped/sour cream,hard cheese}" "{pork,whole milk,butter milk}"
[23] "{pip fruit,butter milk,fruit/vegetable juice}" "{frankfurter,root vegetables,sliced cheese}"
[25] "{butter,whipped/sour cream,sliced cheese}" "{yogurt,oil,coffee}"
[27] "{root vegetables,onions,napkins}" "{sausage,berries,butter}"
[29] "{hamburger meat,tropical fruit,whipped/sour cream}" "{butter,hygiene articles,napkins}"
[31] "{pip fruit,butter,hygiene articles}" "{tropical fruit,butter,hygiene articles}"
[33] "{tropical fruit,domestic eggs,hygiene articles}" "{root vegetables,whipped/sour cream,hygiene articles}"
[35] "{pip fruit,root vegetables,hygiene articles}" "{cream cheese ,domestic eggs,sugar}"
[37] "{other vegetables,cream cheese ,sugar}" "{curd,domestic eggs,sugar}"
[39] "{citrus fruit,domestic eggs,sugar}" "{tropical fruit,domestic eggs,sugar}"
[41] "{yogurt,domestic eggs,sugar}" "{root vegetables,whipped/sour cream,sugar}"
[43] "{pork,rolls/buns,waffles}" "{whipped/sour cream,long life bakery product,napkins}"
[45] "{tropical fruit,long life bakery product,napkins}" "{sausage,butter,long life bakery product}"
[47] "{tropical fruit,dessert,whipped/sour cream}" "{cream cheese ,domestic eggs,napkins}"
[49] "{root vegetables,butter,cream cheese }" "{pip fruit,whipped/sour cream,cream cheese }"
[51] "{sausage,pip fruit,cream cheese }" "{citrus fruit,root vegetables,cream cheese }"
[53] "{root vegetables,butter,white bread}" "{butter,whipped/sour cream,coffee}"
[55] "{root vegetables,domestic eggs,coffee}" "{butter,curd,domestic eggs}"
[57] "{citrus fruit,butter,curd}" "{domestic eggs,margarine,bottled beer}"
[59] "{pip fruit,whipped/sour cream,brown bread}" "{domestic eggs,margarine,fruit/vegetable juice}"
[61] "{butter,whipped/sour cream,soda}" "{pip fruit,butter,pastry}"
[63] "{tropical fruit,whipped/sour cream,fruit/vegetable juice}" "{root vegetables,other vegetables,yogurt,rice}"
[65] "{root vegetables,whole milk,yogurt,rice}" "{tropical fruit,root vegetables,herbs,other vegetables}"
[67] "{tropical fruit,grapes,whole milk,yogurt}" "{tropical fruit,pip fruit,yogurt,frozen meals}"
[69] "{root vegetables,other vegetables,yogurt,hard cheese}" "{ham,tropical fruit,pip fruit,yogurt}"
[71] "{ham,tropical fruit,pip fruit,whole milk}" "{tropical fruit,butter,yogurt,sliced cheese}"
[73] "{tropical fruit,whole milk,butter,sliced cheese}" "{tropical fruit,root vegetables,yogurt,oil}"
[75] "{root vegetables,other vegetables,yogurt,oil}" "{root vegetables,whole milk,yogurt,oil}"
[77] "{root vegetables,other vegetables,yogurt,waffles}" "{other vegetables,curd,whipped/sour cream,cream cheese }"
[79] "{citrus fruit,whole milk,whipped/sour cream,cream cheese }" "{pip fruit,root vegetables,other vegetables,cream cheese }"
[81] "{pip fruit,other vegetables,yogurt,cream cheese }" "{tropical fruit,butter,yogurt,white bread}"
[83] "{tropical fruit,other vegetables,butter,white bread}" "{root vegetables,other vegetables,butter,white bread}"
[85] "{root vegetables,whole milk,butter,white bread}" "{citrus fruit,other vegetables,yogurt,frozen vegetables}"
[87] "{beef,tropical fruit,yogurt,rolls/buns}" "{tropical fruit,curd,yogurt,domestic eggs}"
[89] "{citrus fruit,tropical fruit,curd,yogurt}" "{other vegetables,butter,whipped/sour cream,napkins}"
[91] "{pork,other vegetables,butter,whipped/sour cream}" "{pork,root vegetables,other vegetables,butter}"
[93] "{frankfurter,tropical fruit,root vegetables,yogurt}" "{pip fruit,root vegetables,other vegetables,brown bread}"
[95] "{root vegetables,other vegetables,rolls/buns,brown bread}" "{other vegetables,butter,whipped/sour cream,domestic eggs}"
[97] "{tropical fruit,butter,yogurt,domestic eggs}" "{root vegetables,butter,yogurt,domestic eggs}"
[99] "{tropical fruit,butter,whipped/sour cream,fruit/vegetable juice}" "{whole milk,butter,whipped/sour cream,soda}"
[101] "{citrus fruit,other vegetables,butter,bottled water}" "{whole milk,rolls/buns,soda,newspapers}"
[103] "{pip fruit,other vegetables,whipped/sour cream,domestic eggs}" "{citrus fruit,whole milk,whipped/sour cream,domestic eggs}"
[105] "{tropical fruit,yogurt,whipped/sour cream,domestic eggs}" "{tropical fruit,other vegetables,whipped/sour cream,domestic eggs}"
[107] "{citrus fruit,tropical fruit,other vegetables,domestic eggs}" "{tropical fruit,yogurt,whipped/sour cream,fruit/vegetable juice}"
[109] "{tropical fruit,whole milk,whipped/sour cream,fruit/vegetable juice}" "{pip fruit,root vegetables,yogurt,fruit/vegetable juice}"
[111] "{citrus fruit,other vegetables,soda,fruit/vegetable juice}" "{citrus fruit,whipped/sour cream,rolls/buns,pastry}"
[113] "{citrus fruit,tropical fruit,root vegetables,whipped/sour cream}" "{pip fruit,root vegetables,other vegetables,bottled water}"
[115] "{tropical fruit,root vegetables,yogurt,pastry}" "{sausage,tropical fruit,root vegetables,yogurt}"
[117] "{sausage,tropical fruit,root vegetables,rolls/buns}" "{tropical fruit,root vegetables,rolls/buns,bottled water}"
[119] "{tropical fruit,root vegetables,other vegetables,yogurt,oil}" "{tropical fruit,root vegetables,whole milk,yogurt,oil}"
[121] "{tropical fruit,other vegetables,whole milk,yogurt,oil}" "{tropical fruit,other vegetables,butter,yogurt,domestic eggs}"
[123] "{citrus fruit,root vegetables,whole milk,yogurt,whipped/sour cream}" "{citrus fruit,tropical fruit,root vegetables,whole milk,yogurt}"
Itemsets in Consequent (RHS)
[1] "{root vegetables}" "{yogurt}" "{other vegetables}" "{whole milk}" "{bottled beer}" 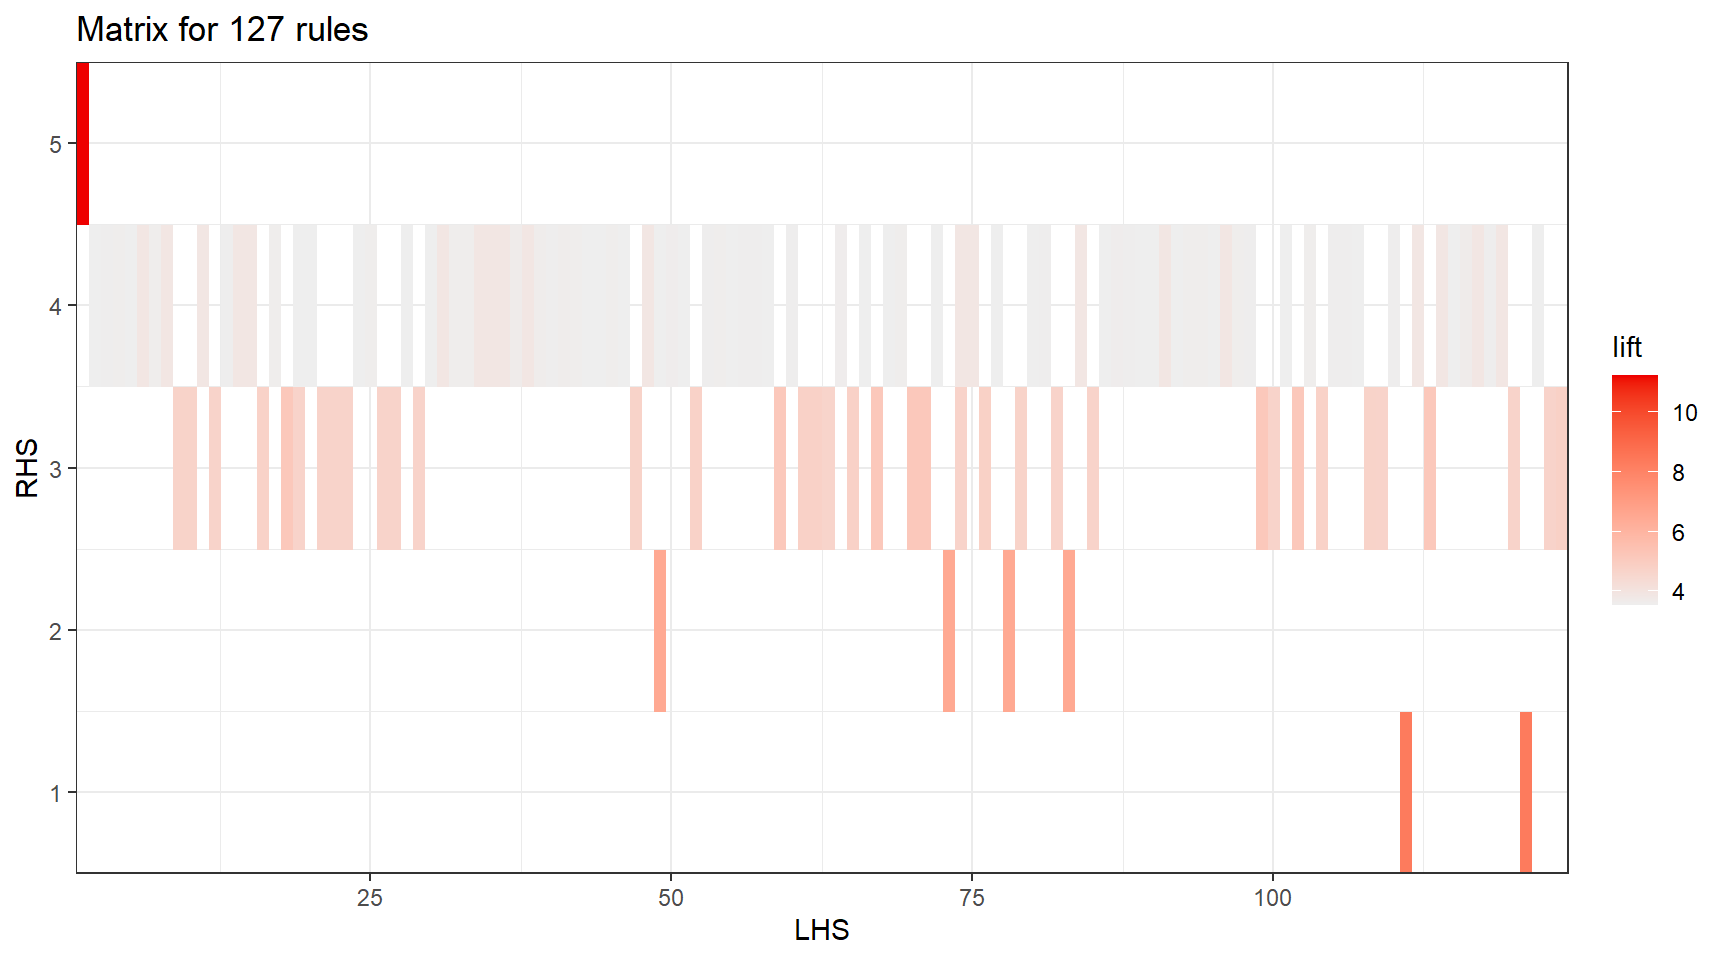
Visualize as 5 principais regras com a maior elevação e plote:
regras_mais_elevadas <- head(sort(regras, by="lift"), 5)
plot(regras_mais_elevadas, method = "graph", control = list(type = "items"))
Available control parameters (with default values):
layout = stress
circular = FALSE
ggraphdots = NULL
edges = <environment>
nodes = <environment>
nodetext = <environment>
colors = c("#EE0000FF", "#EEEEEEFF")
engine = ggplot2
max = 100
verbose = FALSE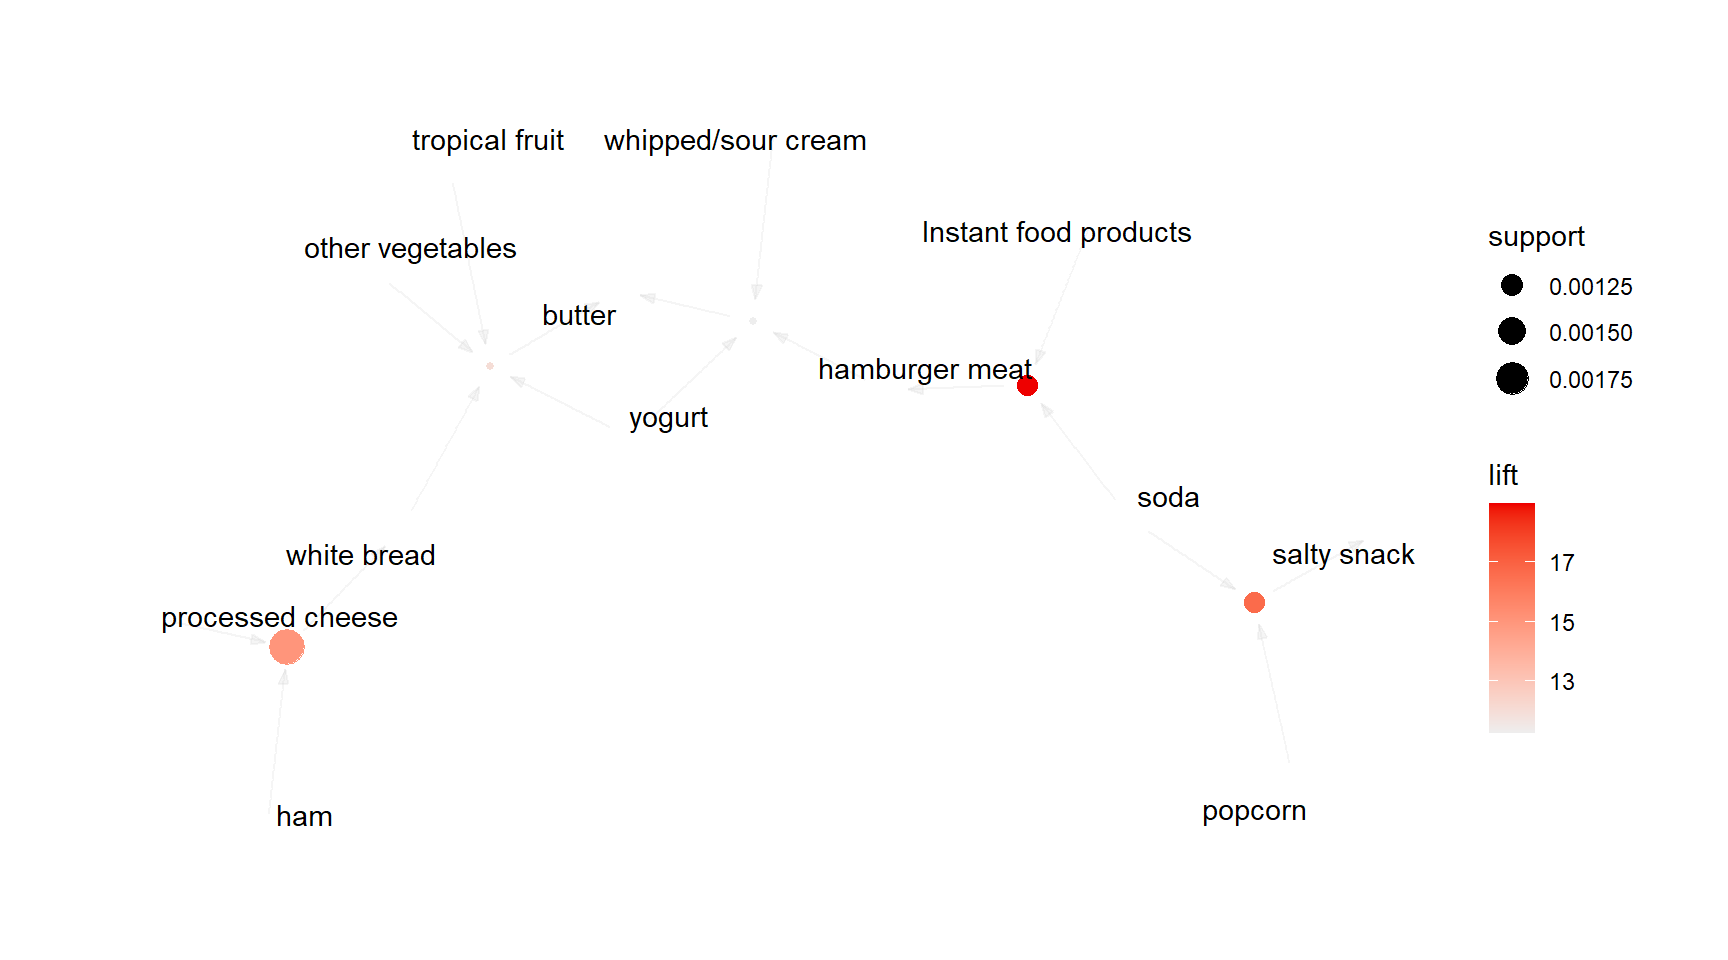
Usamos o conjunto de dados Groceries que possui cerca de
9835 transações que incluem n número de itens que foram
comprados juntos na loja. Ao executar o algoritmo Apriori sobre o
conjunto de dados com um valor de suporte mínimo de 0,01 e confiança
mínima de 0,2, filtramos as regras de associação forte nas transações.
Listamos as 10 primeiras transações acima, juntamente com o gráfico de
caixa dos 20 principais itens com a maior frequência relativa de itens.
Algumas regras de associação que podemos concluir deste programa
são:
- Se o queijo (
hard cheese) for comprado, o leite integral também será comprado. - Se o
buttermilké comprado, o leite integral também é comprado com ele. - Se o
buttermilkfor comprado, outros vegetais também serão comprados juntos.
Além disso, o leite integral tem alto suporte, bem como um valor de confiança. Portanto, será lucrativo colocar o ‘leite integral’ em uma prateleira visível e acessível, pois é um dos itens mais comprados.
Além disso, perto da prateleira onde o ‘leite’ é colocado, deve haver
prateleiras para ‘leite integral’ e ‘outros vegetais’, pois seu valor de
confiança é bastante alto. Portanto, há uma probabilidade maior de
comprá-los junto com o buttermilk. Assim, com ações
semelhantes, podemos almejar aumentar as vendas e os lucros da
mercearia/supermercado analisando os padrões de compra dos usuários.
Exercício 2
Utilizando o dataset iris, muito populamente conhecida
chamamos:
data(iris)

iris <- iris %>%
  rename(
    variety = "Species" # Renomeio de Species para variety

  )

glimpse(iris)
Rows: 150
Columns: 5
$ Sepal.Length <dbl> 5.1, 4.9, 4.7, 4.6, 5.0, 5.4, 4.6, 5.0, 4.4, 4.9, 5.4, 4.8, 4.8, 4.3, 5.8, 5.7, 5.4, 5.1, 5.7, 5.1, 5.4, 5.1, 4.6, 5.1, 4.8, 5.0, 5…
$ Sepal.Width <dbl> 3.5, 3.0, 3.2, 3.1, 3.6, 3.9, 3.4, 3.4, 2.9, 3.1, 3.7, 3.4, 3.0, 3.0, 4.0, 4.4, 3.9, 3.5, 3.8, 3.8, 3.4, 3.7, 3.6, 3.3, 3.4, 3.0, 3…
$ Petal.Length <dbl> 1.4, 1.4, 1.3, 1.5, 1.4, 1.7, 1.4, 1.5, 1.4, 1.5, 1.5, 1.6, 1.4, 1.1, 1.2, 1.5, 1.3, 1.4, 1.7, 1.5, 1.7, 1.5, 1.0, 1.7, 1.9, 1.6, 1…
$ Petal.Width <dbl> 0.2, 0.2, 0.2, 0.2, 0.2, 0.4, 0.3, 0.2, 0.2, 0.1, 0.2, 0.2, 0.1, 0.1, 0.2, 0.4, 0.4, 0.3, 0.3, 0.3, 0.2, 0.4, 0.2, 0.5, 0.2, 0.2, 0…
$ variety <fct> setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, setosa, set…Começando nosso exercício com o Weka:

Em seguida clicamos aba Cluster > Choose > KMeans > Start. Vamos inserir a sequência de prints com os previews de combinações de k para plotarmos o gráfico do número ótimo de clusters pela Soma dos Erros ao quadrado.
- \(k=1\) com RMS = 141.1661

- \(k=2\) com RMS = 62.1277

- \(k=3\) com RMS = 7.8015

- \(k=4\) com RMS = 6.5979

- \(k=5\) com RMS = 6.2776

- \(k=6\) com RMS = 6.5159

- \(k=7\) com RMS = 5.2176

Logo se utilizarmos a inspeção visual pelos resultados das Somas Totais dos Erros Quadráticos gerados pelo Weka teríamos:
RMS_grafico <- data.frame(
  k = c(1, 2, 3, 4, 5, 6, 7),
  RMS = c(141.1661, 62.1277,  7.8015,  6.5979, 6.2776, 6.5159, 5.2176)
)

ggplotly(
  ggplot(RMS_grafico, aes(x = k,
                          y = RMS)) +
    geom_line() + geom_point() +
    geom_vline(xintercept = 3, color = "blue", linetype = "dashed") +
    ggtitle("Gráfico de parada do algoritmo kmeans para a quantidade ótima (k) de clusters geradas com o Weka")  +
  theme(plot.title = element_text(size = 8, face = "bold"))
)
Veja que o decaimento do Erro RMS se inicia bruscamente a partir do segundo pro terceiro cluster.
Podemos resumir os valores estimados da Soma Quadrática dos Erros com o R:
set.seed(123)

iris <- iris %>%
  select(
    -variety
  )

# função para obter o total de soma quadrática intra-clusters
wss <- function(k) {
  kmeans(scale(iris), k, nstart = 10 )$tot.withinss
}

k.values <- 1:10

# extrai wss para os clusters 2 a 15

wss_values <- map_dbl(k.values, wss)

as_tibble(wss_values)
set.seed(123)
fviz_nbclust(scale(iris), kmeans, method = "wss")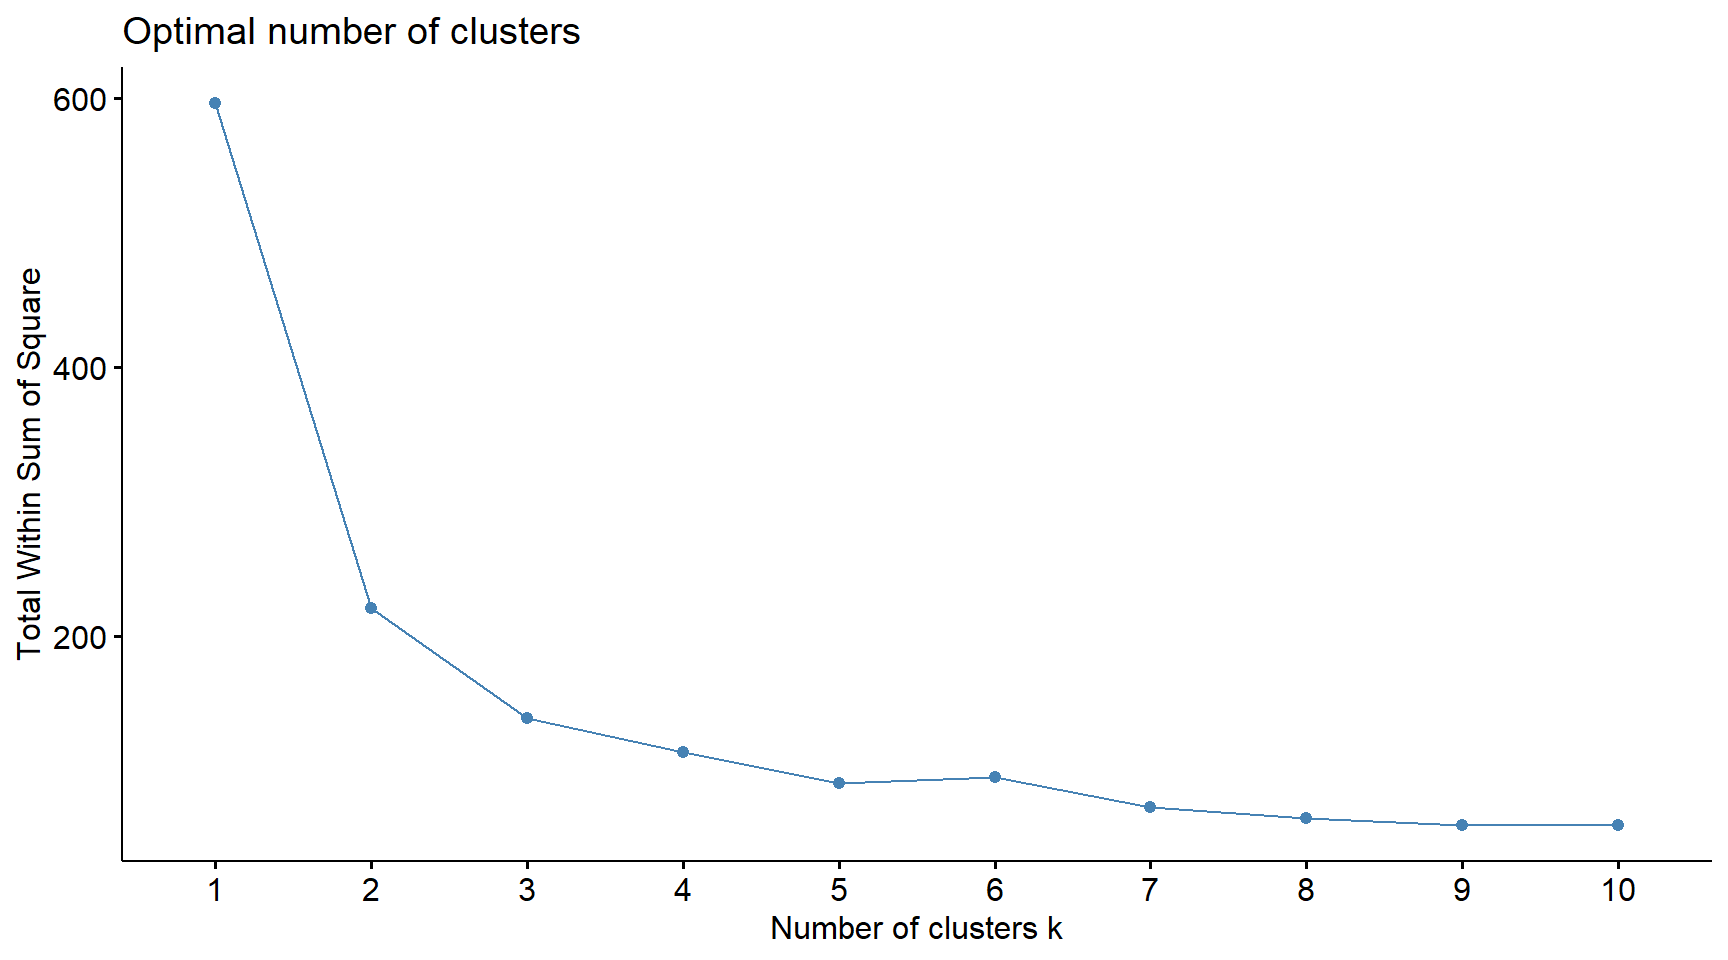
fviz_nbclust(scale(iris), kmeans, method = "silhouette")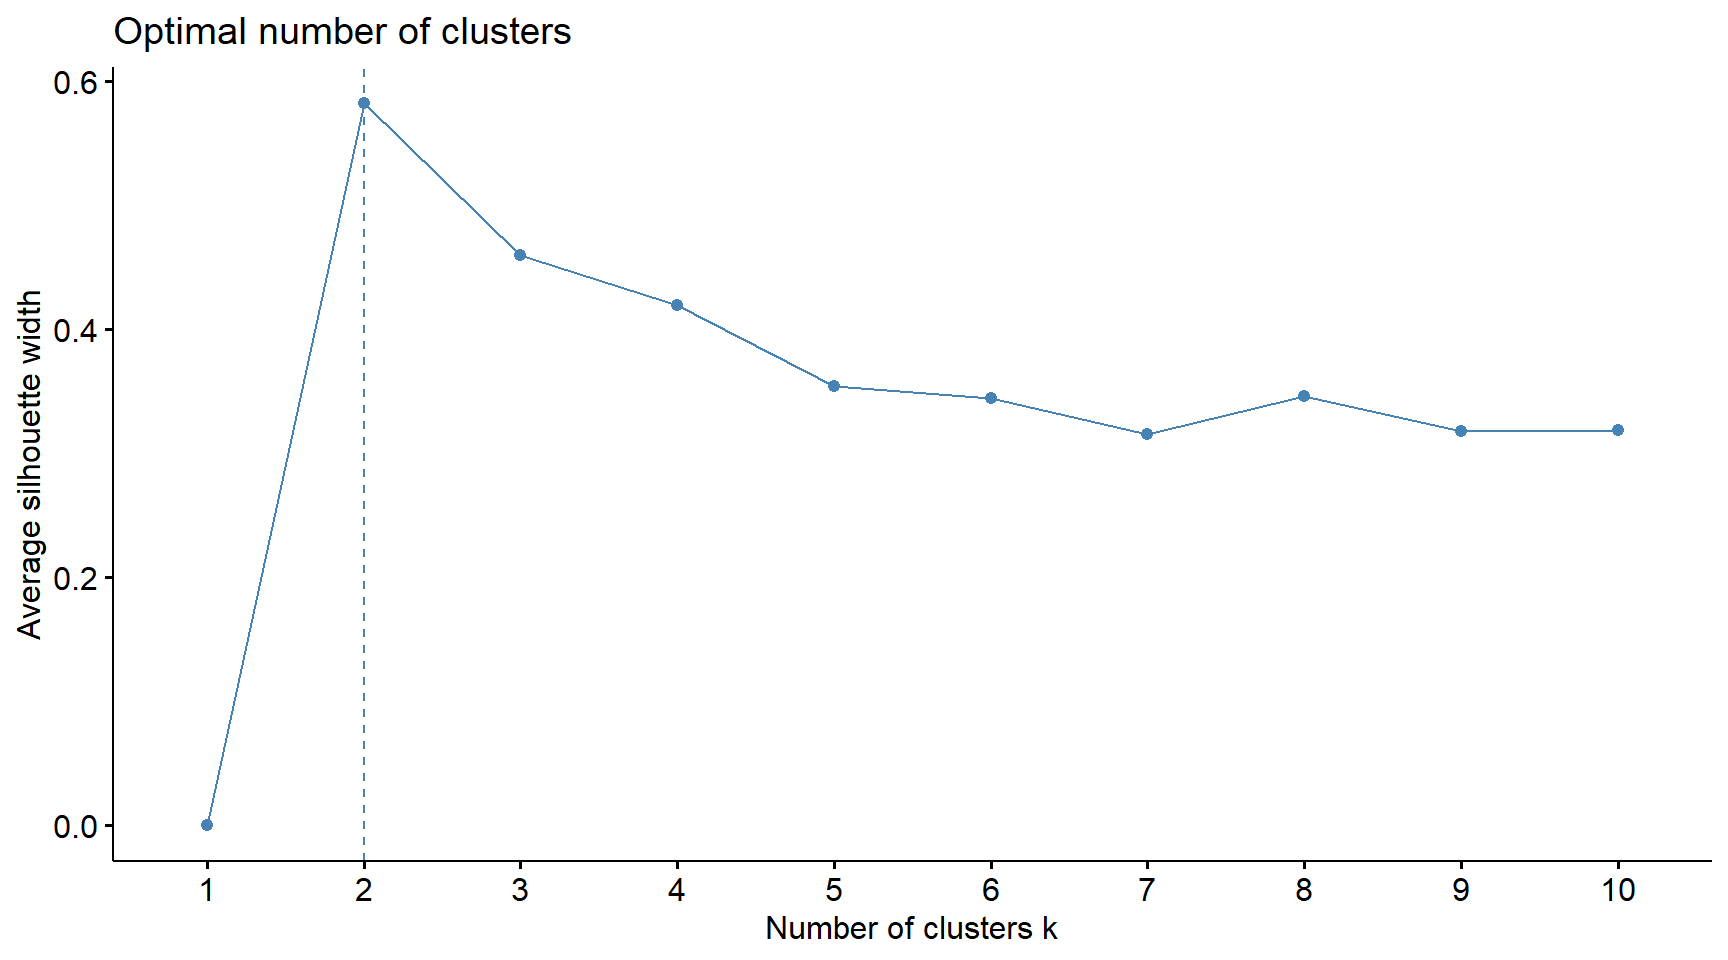
Note, que tanto no Weka quanto no R, notamos que o critério ótimo de
parada do algoritmo KMeans parece estar entre 2 a 3 clusters para o
dataset iris.
Referências
How to use R in Weka in https://riptutorial.com/weka/topic/7916/how-to-use-r-in-weka acesso em Março de 2022.
Apriori Algorithm in R Programming in https://www.geeksforgeeks.org/apriori-algorithm-in-r-programming/